




















Innovative Tech
文章から“動画”を自動作成するAI、中国の研究チームが開発
Innovative Tech:
このコーナーでは、テクノロジーの最新研究を紹介するWebメディア「Seamless」を主宰する山下裕毅氏が執筆。新規性の高い科学論文を山下氏がピックアップし、解説する。
中国の清華大学の研究チームが開発した「CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers」は、簡単なテキストを入力に、その文章を基にした簡単な動画を自動作成する機械学習モデルだ。
以下の画像のように、例えば「A man is sking.」と入力すると、男性が雪の上をスキーで滑る映像を出力し「A lion is drinking water.」だとライオンが手にコップを持ち水を飲む映像を出力する。ここでの映像サンプルは、4秒間の32フレームで解像度480×480で出力される。
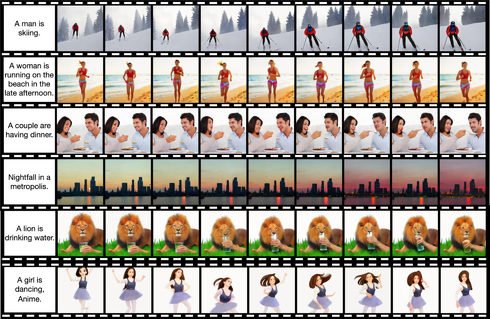 テキスト入力(左端)と生成した映像サンプル
昨今、米OpenAIのDALL-Eや米GoogleのImagen、中国の清華大学によるCogView2などのように、テキストから画像に変換するモデルの精度が高まっている。次のステップとして、テキストから動画に変換するモデルを開発するのは自然なことだろう。
だが、学習用としてキャプション付きの画像ペアを収集することはデータセットも充実しており容易だが、キャプション付きビデオデータを大量に集めるのは容易ではない。画像は止まっているためテキスト情報とペアにしやすく、ビデオは時間的に連続しているためテキストと分割クリップのペアを正確に組み合わせるのが非常に難しいからだ。
例えば、「飲む」動画が、「飲む」という同じテキストで「グラスを持つ」「持ち上げる」「飲む」「置く」という4つの個別クリップに分割されると、モデルは飲むという正確な意味を理解できず学習するのに混乱する。
この研究では、94億個のパラメータを持ち、540万組のテキストとビデオに対して学習された、テキストからビデオを生成する事前学習済みtransformer「CogVideo」を提案する。CogVideoは、テキストから画像を生成するモデル「CogView2」に基づいて構築されており、CogView2の事前学習で得られた知識を継承している。
この手法は、テキストと映像中の時間的な対応関係を確実にするために、マルチフレームレートによる階層的な学習を導入している。これによってテキストとクリップの意味をより良く整合でき、特に複雑な意味を持つ動きに対して生成精度を大幅に向上させることに成功した。
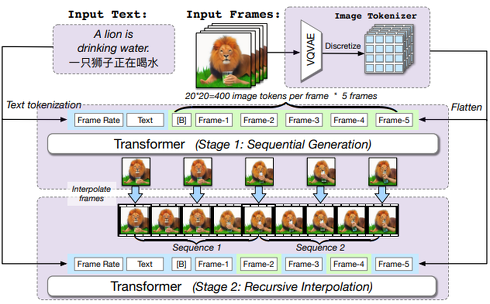 CogVideoにおけるマルチフレームレートの階層的生成フレームワーク
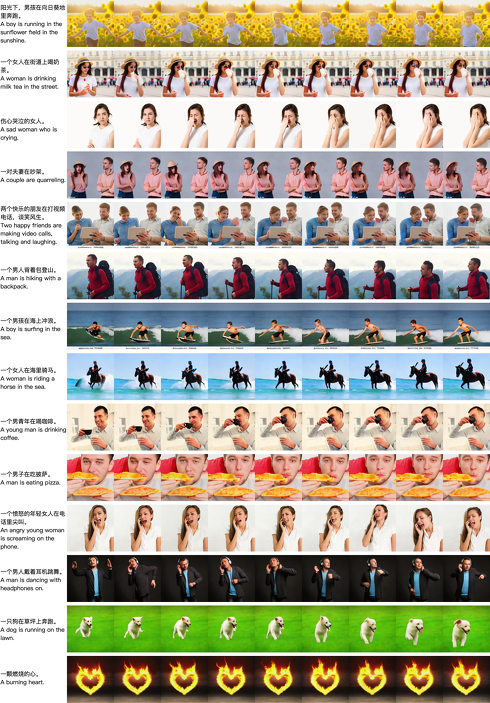 左端が入力のテキストで、それを基に生成されたのが残りの動画シーケンス
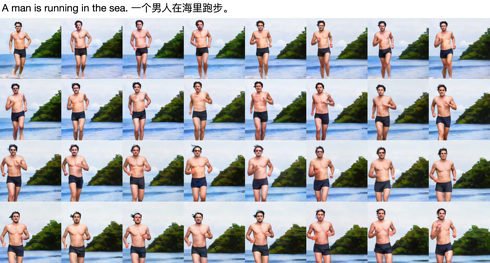 「男が海で走る」を入力に出力された動画シーケンス
Source and Image Credits: Hong, W., Ding, M., Zheng, W., Liu, X., & Tang, J. (2022). CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers. ArXiv, abs/2205.15868.
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
AI学習への利用拒否をrobots.txtで一括指定へ OpenAIやGoogleなどが対応表明
-
2
総務省、GMO攻撃者サイトの「ブロッキング」を通信各社に要請 報道
-
3
楽天カード、本人認証をワンタイムパスワードに統一 27年2月から順次
-
4
日本郵政「ゆうID」不正ログイン、他社で流出したパスワード使うリスト攻撃か……2段階認証必須に
-
5
松屋のアプリに不正アクセス、約238万件の個人情報が漏えい 停止中の補償も予定
-
6
「PayPay連携の銀行から、お金全部盗られた」被害報告……原因と対策は? PayPayに聞いた
-
7
「低評価でキャラが悲しげな目」 モスバーガーのアンケートがSNSで話題 運営会社に狙いを聞いた
-
8
Binanceの約1兆円流出、北朝鮮ハッカー集団「TraderTraitor」の犯行か
-
9
「ITノウハウ持つ人材少なく」 PHP脆弱性問題、31市町村でサイト一時停止継続
-
10
セガのスマホゲーム「チェンクロ」、セキュリティ問題で1~2カ月の長期メンテ 13年続く長寿タイトル
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR