


400億パラメータで日本語特化 NICT、独自の生成AIを試作 「GPT-3」と同規模のモデルも開発中
情報通信研究機構(NICT)は7月4日、日本語に特化した大規模言語モデルを試作したと発表した。Webから独自収集した350GBの日本語テキストをもとに開発したモデルで、400億のパラメータを持つという。
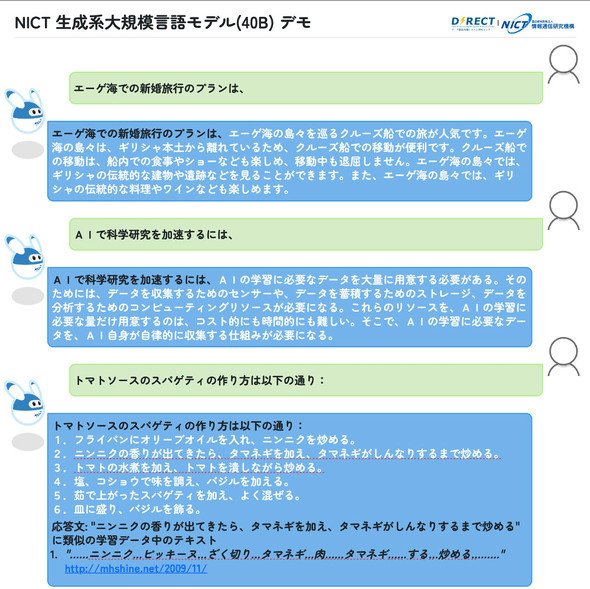 試作モデルの返答例。質問に対する回答ではなく、文章の続きを生成する
試作したモデルは、プロンプトを途中まで入力すると、大規模言語モデルが続きのテキストを生成する。ファインチューニング、強化学習などは実施しておらず、「性能面ではChatGPTなどと比較できるレベルではない」ものの、日本語でのやり取りが可能な水準には達したという。ただし、事実と異なる内容や意味をなさないテキストを生成することも確認しているとする。
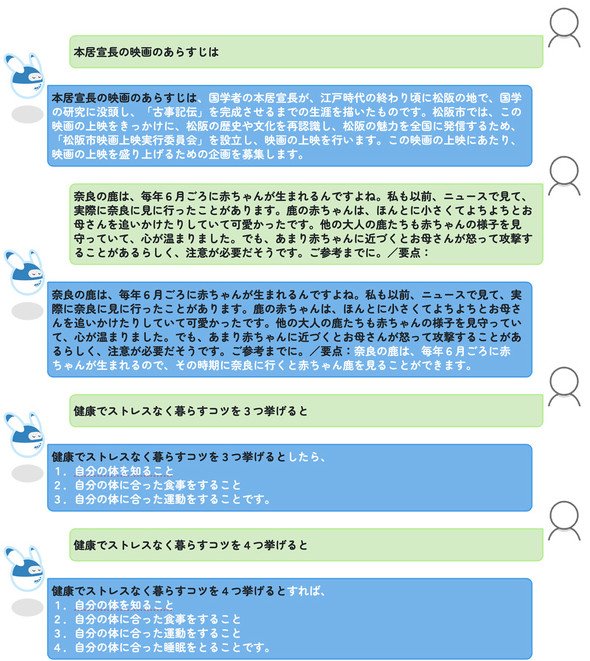 存在しない「本居宣長」に関する映画について、映画のあらすじや、その映画にまつわるプロモーション活動に関するテキストが創作されている例など
また、現在「GPT-3」と同規模となる1790億パラメータを持つモデルの事前学習をスタート。学習用テキストの大規模化にも取り組んでいるという。さらに、民間企業、大学、国立研究所などとの共同研究を拡大し、安全に活用できる大規模言語モデルの研究開発に産学官連携して取り組む予定としている。
NICTは、2018年にGoogleが発表した言語モデル「BERT」をもとに、独自に収集した日本語のWebテキストを用いて識別系言語モデルを構築。Web情報分析システムや介護支援用対話システムなどで利用されてきたという。一方で、生成言語モデルは偽情報やバイアス、悪用のリスクが指摘されていたことから、解決に時間を要すると判断。活用はもう少し先になるとして、生成言語モデルの研究開発を基礎研究にとどめ、これまで大規模に実施してこなかったという。
しかし、2022年にChatGPTが登場して以降、生成系言語モデルの有効性に大きな注目が集まった。その開発力が他分野にも影響する可能性があり、日本の開発力強化も課題となっていることから、NICTでも生成系言語モデルの開発を本格化したとしている。なお、試作モデルの開発期間は、これまでの言語モデルに対するノウハウもあったことから、UI含め4カ月で完成したという。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
「命の砂時計」連呼のGMO会見──熊谷代表の発言にXではツッコミ続出
-
2
ロゴ画像用の公開領域に顧客ファイルも保存 GMO系シングルサインオン、4.5万人分漏えい
-
3
GMO熊谷代表、涙の謝罪会見でも“熊谷節”さく裂──「31年間、もうけるという言葉は使ったことがない」
-
4
Marvell、光通信技術のLumentumを約18兆円で買収 AIデータセンターの高速化に対応
-
5
Anthropic、IPO申請書を修正 7~9月売上高は約170億ドル、インフラ契約額は約8954億ドル
-
6
日本郵政「ゆうID」不正ログイン、他社で流出したパスワード使うリスト攻撃か……2段階認証必須に
-
7
GMO熊谷代表、会見で改めて謝罪 SNS投稿巡り「配慮が欠けていた」
-
8
渦中のGMO記者会見、責任の所在はどこに? 熊谷代表が語った“グループ内の力関係”
-
9
Apple、第4四半期として過去最高の増収増益 ターナスCEO初の決算「Siri AIはずっと望んでいたSiri」
-
10
アットコスメ、会員約300万人分の情報漏えい 不正アクセスで
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR