




















400億パラメータで日本語特化 NICT、独自の生成AIを試作 「GPT-3」と同規模のモデルも開発中
情報通信研究機構(NICT)は7月4日、日本語に特化した大規模言語モデルを試作したと発表した。Webから独自収集した350GBの日本語テキストをもとに開発したモデルで、400億のパラメータを持つという。
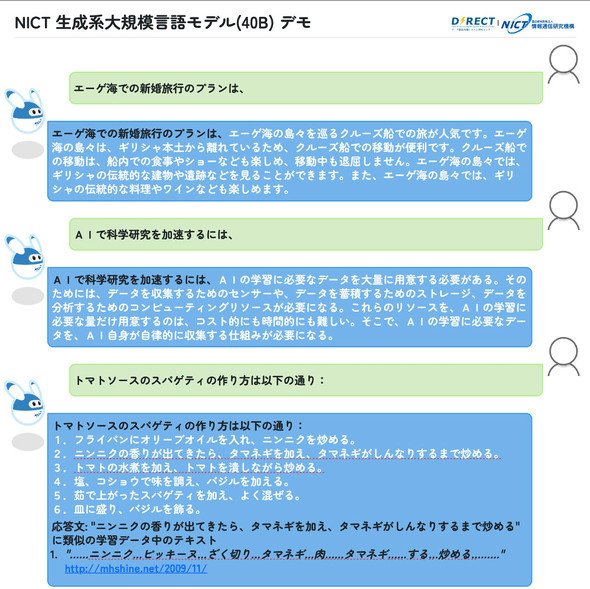 試作モデルの返答例。質問に対する回答ではなく、文章の続きを生成する
試作したモデルは、プロンプトを途中まで入力すると、大規模言語モデルが続きのテキストを生成する。ファインチューニング、強化学習などは実施しておらず、「性能面ではChatGPTなどと比較できるレベルではない」ものの、日本語でのやり取りが可能な水準には達したという。ただし、事実と異なる内容や意味をなさないテキストを生成することも確認しているとする。
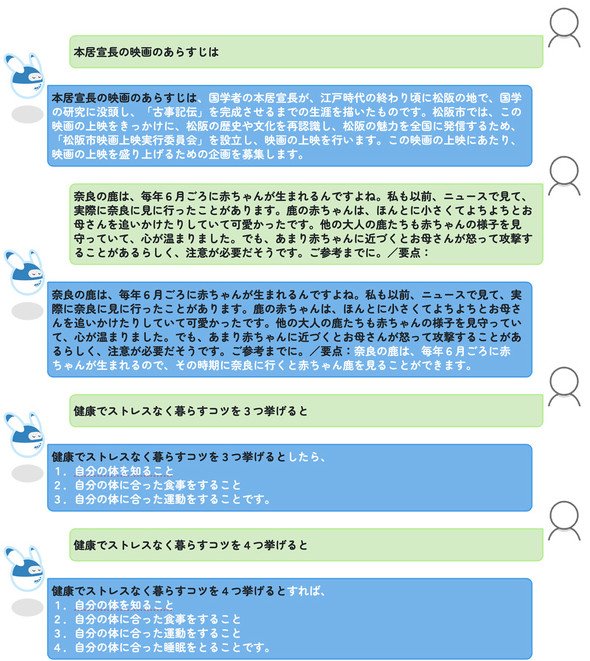 存在しない「本居宣長」に関する映画について、映画のあらすじや、その映画にまつわるプロモーション活動に関するテキストが創作されている例など
また、現在「GPT-3」と同規模となる1790億パラメータを持つモデルの事前学習をスタート。学習用テキストの大規模化にも取り組んでいるという。さらに、民間企業、大学、国立研究所などとの共同研究を拡大し、安全に活用できる大規模言語モデルの研究開発に産学官連携して取り組む予定としている。
NICTは、2018年にGoogleが発表した言語モデル「BERT」をもとに、独自に収集した日本語のWebテキストを用いて識別系言語モデルを構築。Web情報分析システムや介護支援用対話システムなどで利用されてきたという。一方で、生成言語モデルは偽情報やバイアス、悪用のリスクが指摘されていたことから、解決に時間を要すると判断。活用はもう少し先になるとして、生成言語モデルの研究開発を基礎研究にとどめ、これまで大規模に実施してこなかったという。
しかし、2022年にChatGPTが登場して以降、生成系言語モデルの有効性に大きな注目が集まった。その開発力が他分野にも影響する可能性があり、日本の開発力強化も課題となっていることから、NICTでも生成系言語モデルの開発を本格化したとしている。なお、試作モデルの開発期間は、これまでの言語モデルに対するノウハウもあったことから、UI含め4カ月で完成したという。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
資さんうどん、従業員の退職理由などが外部から閲覧可能に 委託先の勤怠システムに設定不備
-
2
NEC、委託先の情報漏えいで謝罪 「セキュリティ事業を手掛ける企業として反省」
-
3
VTuber「兎田ぺこら」グッズにSNSで風評被害→示談成立 「保護者同伴で謝罪などがあったため」
-
4
JALの予約システムに不正アクセス 約9万人分の予約情報が漏えい 一部ではパスポート番号も
-
5
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
6
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
7
「対策を後回しにしたサーバが軒並み狙われている」 相次ぐ不正アクセスにラックCTOが警鐘
-
8
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
9
GMO不正アクセスの犯人サイト、ドメイン停止を確認
-
10
Anthropic、独自の“創薬活動”に着手 社員1人のバイオ企業を買収、小児難病の治療薬研究を進める
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR