




















2030年までに、1兆パラメータを持つLLMの推論コストが90%以上削減される ガートナー予想
この記事は新野淳一氏のブログ「Publickey」に掲載された「マイクロソフト、Claude CodeやGitHub Copilotに「このアプリをデプロイせよ」と指示すればAIが最適なインフラ構成やサービスでデプロイしてくれる「Azure Skills Plugin」公開」(2026年3月25日掲載)を、ITmedia NEWS編集部で一部編集し、転載したものです。
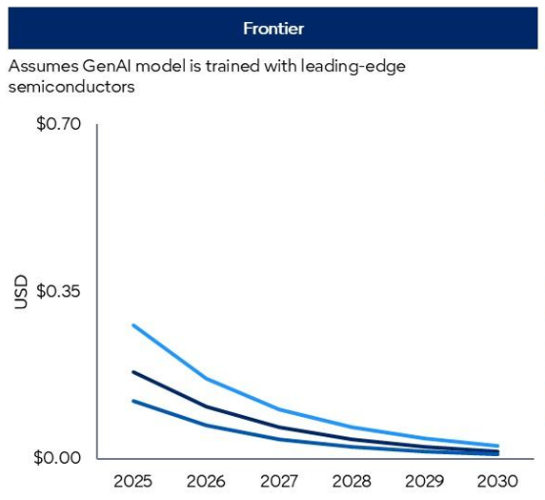
米調査会社のガートナーは、2025年と比較した場合の大規模言語モデルにおける推論実行のコストが、1兆個のパラメータを持つモデルでは2030年までに90%以上削減されるとの予想を発表しました。
この大きなコスト削減効果は、半導体およびインフラにおける処理効率の向上、モデル設計の革新、チップ利用率の向上、推論特化シリコンの利用増加、特定のユースケースに向けたエッジデバイスの応用などの複数の技術改善を組み合わせたことで実現されると、同社のウィル・ソマー氏(シニアディレクター兼アナリスト)は述べています。
この予想は2つのシナリオに分かれています。
1つは、最先端のチップ技術を前提とした「フロンティアシナリオ」(最前線シナリオ)です。
そしてもう1つは、既存の半導体の代表的なベンチマークを基にした「レガシーブレンドシナリオ」です。
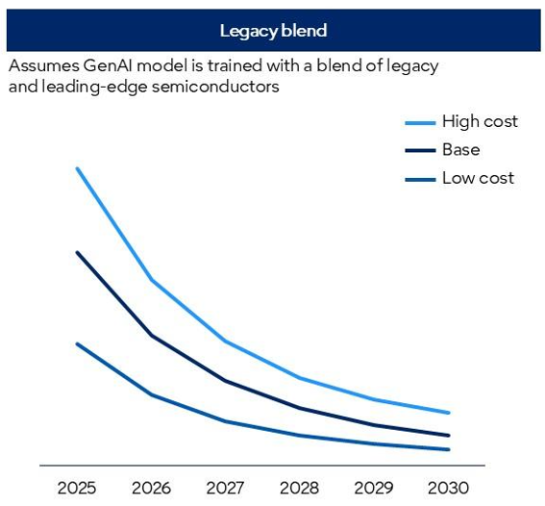
いずれのシナリオでも処理コストは大きく削減されると予想されていますが、「レガシーブレンドシナリオ」は処理能力を低く想定しているケースにおいて、その絶対的コストは「フロンティア」シナリオよりもかなり高くなっています。
処理コストの削減がそのまま利用コストに結びつかない
ただし、こうしたLLMの処理コスト削減が、そのまま利用する企業側におけるAIのコスト削減には結びつかないとガートナーは警告しています。
それは一般的な生成AIのチャットbotの利用に比べて5倍から30倍のトークンが処理されるAIエージェントの利用が企業で広まることで、全体としてはより多くのトークンを処理することになり、それがトークンあたりの処理コスト削減の効果を打ち消してしまうからだと説明されています。
今後企業がコスト面で効率的に生成AIを活用するには、日常的で高頻度なタスクについては安価な小規模かつドメイン固有の言語モデルで処理し、高度で複雑な処理のみ高コストが想定される本格的に大規模な言語モデルで処理すべきだとガートナーはアドバイスしています。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
資さんうどん、従業員の退職理由などが外部から閲覧可能に 委託先の勤怠システムに設定不備
-
2
NEC、委託先の情報漏えいで謝罪 「セキュリティ事業を手掛ける企業として反省」
-
3
VTuber「兎田ぺこら」グッズにSNSで風評被害→示談成立 「保護者同伴で謝罪などがあったため」
-
4
JALの予約システムに不正アクセス 約9万人分の予約情報が漏えい 一部ではパスポート番号も
-
5
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
6
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
7
Anthropic、独自の“創薬活動”に着手 社員1人のバイオ企業を買収、小児難病の治療薬研究を進める
-
8
GMO不正アクセスの犯人サイト、ドメイン停止を確認
-
9
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
10
「対策を後回しにしたサーバが軒並み狙われている」 相次ぐ不正アクセスにラックCTOが警鐘
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR