



















PFNとTenstorrentがタッグ、生成AI特化プロセッサ開発へ 超高メモリ帯域幅、光電融合技術を実装
Preferred Networks(以下、PFN)と米Tenstorrentは10月20日、AIの学習・推論を高性能・高効率に実行可能な生成AI向けプロセッサを含むシステム開発を共同で始めたと発表した。CPUの開発は米Tenstorrentが担い、米NVIDIAのGPUがデファクトスタンダードとなっている「AIプロセッサ」の開発はPFNが担う。光電融合技術と最先端パッケージング技術を活用し、AIプロセッサのシステム化技術の開発を2社で行う。
 Preferred NetworksとTenstorrentが協業|Preferred Networks
国立研究開発法人新エネルギー・産業技術総合開発機構(NEDO)の公募に採択された。2031年度まで研究開発を進め、期間終了後には研究成果の事業化を目指す。
Tenstorrentは米AMDやApple、Teslaでチップ設計を手がけたジム・ケラー氏が率いる半導体開発企業。オープンソースな命令セットアーキテクチャ「RISC-V」(リスク・ファイブ)ベースのプロセッサを開発している。GPUに代わるAIプロセッサとして「Blackhole」などを出荷している他、RISC-V CPUとして「Ascalon」も提供している。日本国内では、半導体製造・開発のRapidusと共同で2nmロジック技術によるエッジAIアクセラレータの開発を進めている。
PFNは、国産LLM「PLaMo」の開発の他、神戸大学と共同でAI計算の要となる「行列演算」に最適化した専用プロセッサ「MN-Core」を開発している。消費電力を抑えながら演算性能を高めているのが特徴で、スーパーコンピュータの世界ランキングでは省電力分野で世界一を3回獲得している。
MN-Coreシリーズの次世代モデルとしては「L1000」の開発を2024年11月に発表済み。「メモリ帯域幅」を広く持つことで、LLMの推論速度を向上させる。L1000を搭載するワークステーションでは、700億(70B)パラメータ規模のLLMで500~1000トークン/秒程度の推論速度を出せるとしている。また、さらに将来の世代では「単一ノードで128Kコンテキスト長の1Tモデル推論を、約500トークン/秒の速度で実現できると考えている」ともしている。なお、L1000の提供予定は当初2026年としていたが、現在は2027年に修正している。
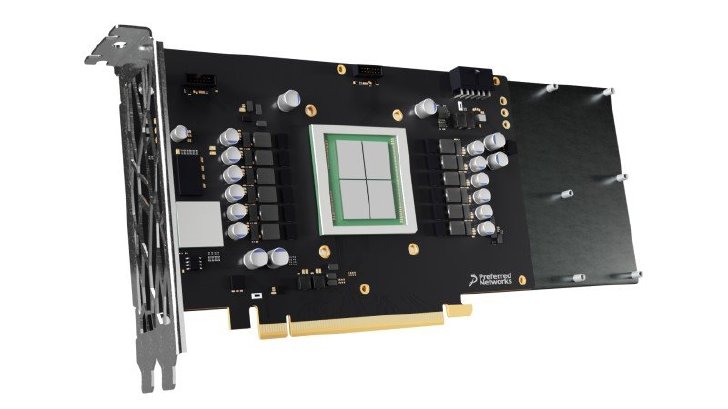 「MN-Core L1000」(CGイメージ)
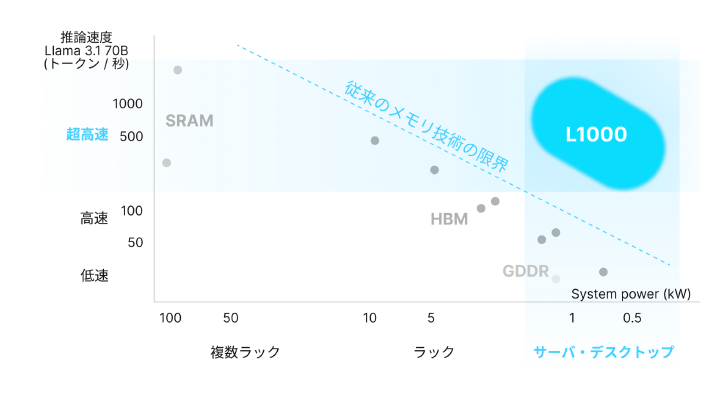 L1000のポジショニングマップ。複数ラックで超高速推論を可能とする他社に比べ、サーバ・デスクトップサイズで同等の推論速度をうたう
高メモリ帯域幅のAI特化プロセッサでは、米Cerebrasや米Groqが先行している。Cerebrasは米OpenAIと提携しており、ChatGPTの「Ultrafast」モードの推論基盤の一部となっている。GroqはNVIDIAが、同社の技術に対する非独占的ライセンスを200億米ドルで取得。次世代AIスーパーコンピュータ「Vera Rubin」の一部として提供される。
光電融合技術は、電気の代わりにできるだけ光を使ってデータを転送する技術のこと。電気に比べて消費電力を抑えながら大容量通信を可能とする。AI計算においては、複数のノードをまたいで効率的に計算するために重要な技術となる。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
デジタル庁、政府職員18万人にAIエージェント環境を展開──「源内」で提供開始、独自の安全基準も
-
2
AI活用で約2900時間削減した世田谷区、しかし「確認と修正の負担」増加 新たな課題どう対応?
-
3
なぜGoogleは、OpenAIとAnthropicに勝てないのか? 「世界最大の計算資源」の使い道
-
4
ネットバンキングにログインしたまま別作業は危険? 「ChatGPT Atlas」などのAIブラウザ7種でデータ窃取を検証
-
5
「どの国のモデルか」は本質ではない 「中国製LLMは危険な指示を実行」発言で話題の専門家に補足してもらった
-
6
“テスラ超え”狙う――チューリング「完全自動運転」までの道 「GPUより速いチップ」使った開発のウラ側
-
7
AI活用で「年3万5000時間削減」の江戸川区 「配って終わり」にさせないコツは? 5年で培った実践知を聞く
-
8
Anthropic、社内でAIエージェントの稼働時間が人間の6倍に 技術系初級職の採用比率は27%→9%に激減
-
9
「言い訳文化」から脱却のNECが足立区に伝授した生成AI活用術とは データ活用“逆算”の鉄則
-
10
ChatGPT広告は誰に何を表示しているのか? 米大学が91のおとりアカウントで実態調査
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR