中古GPUは企業のAI基盤になるか エクストリームーDら3社が「循環型GPUサーバ」を提供
AIインフラ用の最新GPUは高額で納期も長い。エクストリームーDら3社は、使用済みのGPUサーバをAI基盤として再活用するサービスを始めた。旧世代GPUのメモリ容量の制約や、機器の来歴への懸念にどう対応するのか。
AIやHPC(高性能計算)向けのクラウドサービスを手掛けるエクストリームーDは2026年10月20日、AIインフラサービス「Raplase RCA」の提供を開始した。TES-AMM JAPAN(以下、TES-AMM)とCornelis Networks(以下、Cornelis)との協業によるサービスだ。TES-AMMはIT機器の回収やデータ消去、リユースを、CornelisはAIやHPC向けのネットワーク製品を手掛ける。
Raplase RCAは、一定期間使用されたGPUサーバを再活用した「循環型GPUサーバ」をAI基盤として提供する。専有と共有の2つの利用形式があり、共有形式では最小1GPUから利用できる。在庫がある機種なら、申し込みから最短即日で利用を開始できるという。
ただし、旧世代のGPUにはメモリ容量の制約があり、使用済みの機器には、来歴が分からないという懸念もある。3社はこうした制約や懸念にどう解消するのか。
なぜ循環型GPUサーバなのか
エクストリームーDの柴田直樹氏(代表取締役CEO 兼 CTO)は、同日の記者発表でAIインフラの購入価格がこの1年半ほどで大きく上がったと説明した。以前の購入額の倍程度の金額を提示される顧客も少なくないという。納期についても、機種によっては8~9カ月を提示される例があるとした。
また同氏は、企業が最新GPUの性能を使い切れるとは限らないとも指摘する。そこで同社が着目したのが、旧世代のGPUを搭載したサーバだ。同氏によると、米国のGPUクラウド専業事業者でも、2020年に発売されたNVIDIAのGPU「A100」を搭載したサーバについて、当初の契約を終えた後に新たな契約を結ぶ例が増えているという。
Raplase RCAは、エクストリームーDのAIやHPC向けプラットフォームサービス「Raplase」の新たな提供形態に当たる。従来の提供形態「Raplase AI Next」では、顧客がクラウドやオンプレミスサーバなどのインフラを選ぶ必要があった。Raplase RCAは基本的に、エクストリームーDがデータセンターに用意した循環型GPUサーバをクラウドのように利用する形で提供する。顧客はサブスクリプション契約でインフラを利用する。顧客の拠点に機器を設置するオンプレミス型もオプションとして用意する。Raplaseは、OSを導入したサーバにローカルLLMの実行環境を20~30分程度で自動構築する機能を持ち、Webブラウザから利用できる。
本事業では、3社が次の役割を担う。
- エクストリームーD: Raplase RCAの提供、GPUサーバの性能最適化と運用
- TES-AMM: ITAD(IT資産処分)を通じたGPUサーバの調達と供給
- Cornelis: 複数のGPUサーバを接続する高速・低遅延ネットワークの提供
循環型GPUサーバの弱点をどう補うか
柴田氏は、旧世代のGPUを使う際の最大の課題としてGPUメモリの容量を挙げる。容量が足りなければ、規模の大きなLLMを実行できないためだ。Raplase RCAは、富士通のミドルウェア「AI Computing Broker」とエクストリームーDのチューニング技術を組み合わせ、GPUメモリをホストメモリと連携させて拡張する。これにより、旧世代のGPUではメモリ容量が足りないモデルも実行できるという。
GPUサーバ同士は、Cornelisの400Gbps対応ネットワーク製品「CN5000」で接続する。Cornelisの山﨑拓慈氏(日本・アジア太平洋地域統括)は、GPUの計算性能が向上する一方でネットワークがボトルネックとなり、計算資源を十分に活用できていないという課題がある。
機器の来歴については、TES-AMMが前所有者の情報や使用履歴を把握する。TES-AMMはデータの消去と動作確認を済ませた機器を供給し、エクストリームーDはそれらを在庫として確保する。設置場所として、エクストリームーDは大手データセンター事業者の、AI基盤に対応したデータセンターを確保している。柴田氏によると、顧客に来歴の情報を開示することも検討しているという。機器は主に国内から調達するが、海外から調達した場合も国内のデータセンターに設置して提供する方針だ。
利用形式は次の2つで、いずれも仮想化しないベアメタルで提供する。
- 専有形式: サーバを1台丸ごと利用する。顧客の拠点への設置にも対応する
- 共有形式: 1台のサーバを複数の利用者で共有し、1GPU単位で利用する。各利用者には物理GPUを専有で割り当て、割り当てたGPUは他の利用者から見えない。Dockerコンテナの持ち込みやマルチGPUにも対応する
インスタンスは、NVIDIAの「H100」「A100」「RTX A6000」「RTX PRO 6000 Blackwell Server Edition」を搭載したものを用意する。循環型GPUサーバには、旧世代のGPUだけでなく、比較的新しい世代のGPUを搭載した機種も含まれる。発表時点で在庫があるのはRTX PRO 6000 Blackwell Server Editionで、H100とA100は予約を受け付けている。3社は、RTX A6000を小規模なPoC(概念実証)に向く機種と位置付けている。後日から利用したい場合は、事前に予約しておくこともできる。また、利用シナリオや利用人数に応じて、適したサーバ構成を提示する機能も備える。構成が用途に合わない場合は、1カ月単位で変更できる。
料金は、RaplaseのWebサービスと循環型インスタンスの利用料を合算したサブスクリプション形式で、月額と年額を用意する。価格について柴田氏は、各社のGPUクラウドの1GPU当たりの時間単価を参考に、データセンターや運用、ソフトウェアを含めた料金を設定すると説明した。具体的な料金は公表していない。
エクストリームーDは、2027年3月までに初期顧客10件以上の獲得を目指す。その後、2027年に提供機種の拡大と販売網の本格展開を進め、2029年以降は海外展開も視野に入れる。
記者発表の質疑応答で、ハードウェアが故障した場合の保守運用について柴田氏に尋ねた。同氏によると、故障への対応を顧客に求めることは基本的にない。エクストリームーDはスーパーコンピュータの運用技術を基に複数のインフラを束ねて運用しており、1台が故障してもサービスが止まらない設計にしているという。データセンターで提供する環境の運用とサポートは全て同社が担うという。
柴田氏によると循環型GPUサーバは新品に比べて寿命が短い可能性がある。そこで同社は、一定数の予備機をデータセンターに待機させ、障害が起きた際に自動で切り替える仕組みを新たに導入した。同氏は、保守運用の面では一般的なAIクラウド事業者と大きく変わらないとの考えを示した。
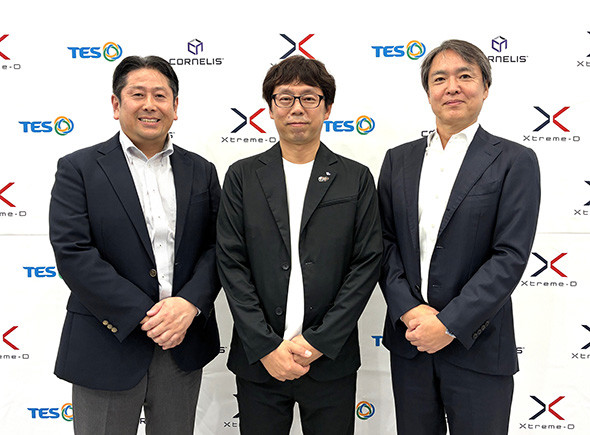 左からTES-AMM JAPANの小沢国彦氏(代表取締役)、エクストリームーDの柴田直樹氏、Cornelis Networksの山﨑拓慈氏(日本・アジア太平洋地域統括)(提供:エクストリームーD)
Copyright © ITmedia, Inc. All Rights Reserved.
本記事は制作段階でChatGPT等の生成系AIサービスを利用していますが、文責は編集部に帰属します。

アイティメディアからのお知らせ
注目のテーマ
人気記事ランキング
- 相次ぐ個人情報漏えいの一因「A2B攻撃」 正体は20年前から言われ続けた“あの教訓”だった
- 「流出なし」で終わらないIDCFクラウド障害 「何をいつまで預けたか」で分かれた明暗
- 不正アクセス多発、Gartnerが日本企業に「7つのアクション」を緊急提言
- ソースネクスト、ヤマトなど数十社2026年10月総まとめ第2弾 やまぬ情報漏えい2週間を振り返る
- セキュリティインシデント9カ月で607件、既に2025年超え 「公表が増えただけ」ではない理由
- 漏えい公表ラッシュは「検知の向上」か「攻撃の増加」か 専門家に聞いた
- Windows 11の自動復旧機能、企業PCは既定でオフ 有効化前にIT部門が決めるべきこと
- AIで揺れた転職市場、なぜ情シスは「決まらない」のか 2026年の転職を阻む3つの構造
- Active Directoryが“人質”に ランサムウェアを使わない恐喝攻撃の手口とは
- Googleの「AppSheet」を悪用した新手のフィッシング攻撃に注意 初回メールに不正リンクがない事例も
 ITmediaはアイティメディア株式会社の登録商標です。