




















クラウド活用できない企業によくある4つの問題点 “脱オンプレ思考”の必要性(2/3 ページ)
ベンダーに丸投げとは一味違う、クラウド時代の障害対応
もう一つ、クラウド活用の障壁になるオンプレ思考の例として挙げられるのは、障害対応に関する考え方だ。
オンプレの場合、物理サーバからアプリまで全て“お抱えベンダー”が面倒を見てくれる場合が多かった。しかしクラウドになるとそうはいかない。例えばIaaSでは物理サーバや物理ネットワークはクラウドベンダーが面倒を見ることになる。
IT部門がお抱えベンダーに丸投げしていた場合、障害が起きたら、その原因調査、対応の経過、再発防止策の立案までこと細やかに報告させていた。IT部門はこの報告をさせ、再発防止策を取り付けることに、その存在意義を見いだしていた面もある。
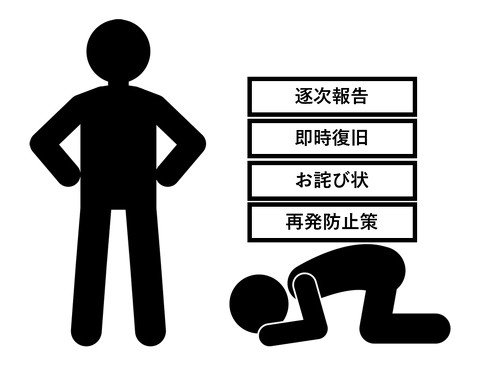 これまでの障害対応のイメージ
しかし、クラウドで障害が発生しても個別連絡は来ない。クラウドベンダーの専任担当者を雇えば連絡を受けられるが、通常はWebページ上に掲載される経過報告を確認することになる。クラウド事業者にとっては障害は起きるもので「可用性が必要なら冗長化(あえて設備や装置を過剰にし、一部が故障しても運用を続けられるようにすること)してください。冗長化の手段は提供しています」という立場だからだ。
一部のIT部門にはこれがつらい。オンプレミスの場合、上長から障害状況を聞かれても、「○○システムが停止しています。いまベンダーがハードを見て原因確認しています。○○時までには原因が解明するはずです」と現状と今後の見通しを答えられていた。しかし、このノリをクラウドで求められると厳しい。例えばこんな感じになる。
「クラウドで障害が起きています。○○システムは可用性がそこまで必要でないシステムだったので冗長化しておらず停止しています。障害の原因はクラウドベンダーが調べているはずです」
こんな話をオンプレ思考の上長にしたら大変だ。こんな回答が返ってくるかもしれない。
「客のシステムを停めておいて報告がないとはどういうことだ! ちゃんと調べさせろ! いつ直るんだ!」
こんな具合で“激詰め”されるかもしれない。IT部門にとっては、クラウド障害と上長の板挟みになってしまうわけだ。
もちろん、クラウドベンダーの専任担当者を雇えばこの問題は緩和できる。しかし、そもそも担当者を雇える会社はこんな状態にはならない。事態を改善するには、考え方を変えるしかないのだ。
そもそも機械は壊れるものなので、障害は必ず起こる。そして、クラウドでは障害対応に向け冗長構成を取れるので、求められる可用性に応じた冗長性を確保すべきである。重要度が低いシステムで冗長化しないならば、障害時はクラウドベンダーによる復旧を待つべきだろう。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
GMO、不正アクセス実行犯の手がかりに懸賞金 1億5000万円規模
-
4
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
5
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
6
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
7
So-net、会員情報約259万件が漏えい 一部メールサービスではパスワードも流出
-
8
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
9
「自分の個人情報が漏えいした……どうすれば?」 IPAが対処法公開
-
10
IPO目論見書に「AIは人類の存亡リスク」「コードの9割はClaude製」 Anthropicが示した規格外の見立て
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR