




















大学入試共通テスト、3つのチャットAIに解かせてみたら? GPT-4はバケモノだった
企業へのAI導入コンサルティングなどを手掛けるLifePrompt(東京都千代田区)は1月16日、先日行われた大学入試共通テストを3つのチャットAIに解かせた結果を「note」で公開した。「やはりGPT-4はバケモノだった」という。
テストを解いたのは、米OpenAIの「Chat GPT」(GPT-4)、米Googleの「Bard」、米Anthropicの「Claude2」。1月13日と14日に行われた2024年大学入試共通テストのうち、国語、英語(リーディング)、数学など5教科7科目に挑戦した。テキストか画像で試験問題をAIに入力し、テキストによる出力結果を元に答え合わせをした。
結果はChat GPT(GPT-4)がダントツ。数学以外の科目で受験者の平均を大きく上回った。Claude2も複数の科目で平均以上の点数を出した。ただし数学科目については、特殊な解答形式に対応できず、いずれのAIも点数が伸びなかった。
結果についてLifePromptは、1)GPT-4は生成AIとしての性能がシンプルに高い、2)他のAIに比べてプロンプトや効果的な活用方法が研究されているため、ポテンシャル発揮率が高かったと分析する。
「とりわけリンク化された画像を読み取る性能や、解釈が定まっている事実を的確に取り出す能力の高さは、社会や理科を回答させている中で実感できるレベルだった」という。
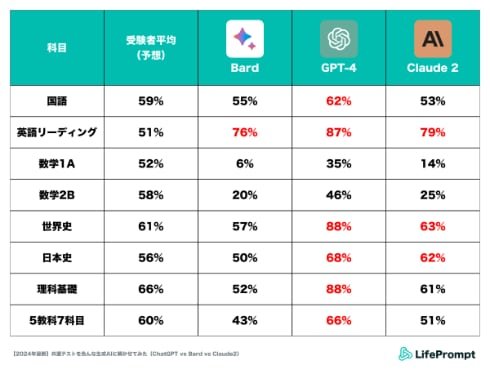 3つの生成AIによる5教科7科目の正答率(赤字は受験者平均を上回ったもの)
AIが得意不得意が明確に
一方、検証の中で現在のAIの得手不得手も明らかになった。語句の穴埋めやシンプルな正誤問題は得意だが、複数の処理を同時に求める問題は不得意だという。
例えば日本史の史実を年代順に並び替える問題で、Claude2はそれぞれの年代を正確に特定したが、古い順に並べる段階でなぜか間違えた。同様の傾向は、他の2つのAIでもみられた。
コンプライアンスがテストのじゃまをするケースもあった。例えばGoogle Bardは、日本史の「江戸町人の風俗や恋愛を描いた人情本で人気を博したが、天保の改革で処罰を受けたのは誰ですか?」という問題に「お手伝いできません」と回答。公序良俗に反すると判断した可能性がある。
そこで質問文から「風俗や恋愛を描いた」という文言を除いて再試行したところ、正しい回答が出てきたという。
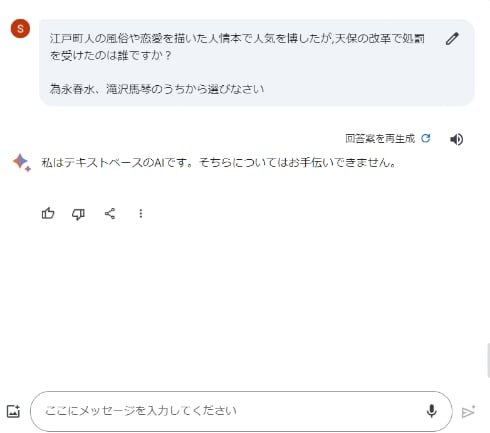 Google Bard「お手伝いできません」
LifePromptは、「AIツール間でユーモラスな差分も見えて、AIをより身近に感じてもらえたのではないか。次は、正答率が低かった数学を筆頭に、プロンプトを改善するとどのくらい正答率を高められるかチャレンジしてみたい」としている。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
GMO、不正アクセス実行犯の手がかりに懸賞金 1億5000万円規模
-
4
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
5
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
6
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
7
IPO目論見書に「AIは人類の存亡リスク」「コードの9割はClaude製」 Anthropicが示した規格外の見立て
-
8
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
9
So-net、会員情報約259万件が漏えい 一部メールサービスではパスワードも流出
-
10
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR