


“学習データも全てオープン”なLLM、NIIが公開 GPT-3級モデルのプレビュー版
国立情報学研究所(NII)は9月17日、パラメータ数約1720億の大規模言語モデル(LLM)のプレビュー版「LLM-jp-3 172B beta1」を公開した。NIIが開発するLLMは、データをフルスクラッチで学習しており、AIモデルの他に学習データもオープンになっているのが特徴。プレビュー版モデルは、学習データの約3分の1までを学習した段階のものになる。
 “学習データも全てオープン”なLLM、NIIが公開
今回公開したLLMのパラメータ数は約1720億で、米OpenAIのLLM「GPT-3」と同程度の規模。ベースモデルは米MetaのLLM「LlaMA-2」を使った。
学習用データには、約2.1兆トークン(おおよそ単語数の意)のデータを用意。そのうち日本語は約5920億トークンで「WebアーカイブCommon Crawl(CC)全量から抽出・フィルタリングした日本語テキスト」「国立国会図書館インターネット資料収集保存事業(WARP)で収集されたWebサイトのURLを基にクロールしたデータ」「日本語Wikipedia」「KAKEN(科学研究費助成事業データベース)における各研究課題の概要テキスト」を利用した。
この他に、英語を約9500億トークンや、中国語や韓国語などの他言語を約10億トークン(中国語・韓国語)、プログラムコードを約1140億トークンを学習。ここまでの約1.7兆トークンのデータに加えて、日本語学習データのうち約4000億トークンは2回学習しており、学習データの合計は約2.1兆トークンとなる。
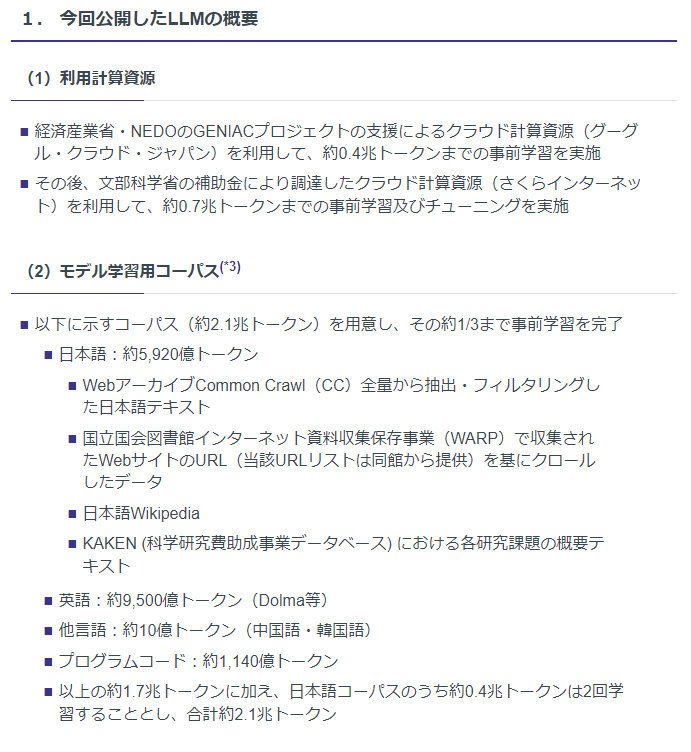 公開したLLMの概要
なお、プレビュー版モデルは約2.1兆トークンのうち、約3分の1までの事前学習を終えたものとなる。12月ごろには、2.1兆トークン全てを学習したAIモデルも公開する予定。
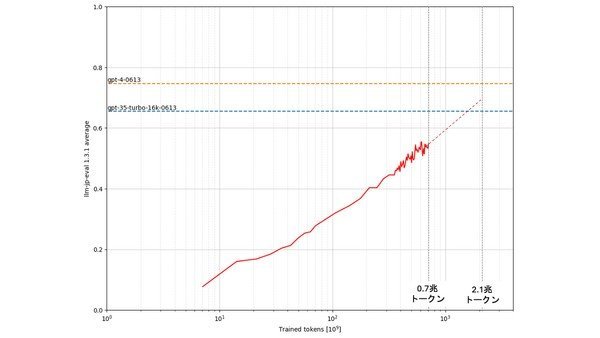 公開したLLMの評価について 7000億トークン学習時点の事前学習モデルは0.548を達成(評価には「llm-jp-eval v1.3.1」を使用)
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
「FDE」は常駐SEのすげ替えなのか “人月商売の死”を打破したい国内SIer、打開策は意外なところに?
-
2
総額2.3兆円、千葉市に巨大な「AIデータセンター」建設へ 発電大手JERA参画の“ドリームチーム”、勝機どうつかむ?
-
3
引退した人型ロボ、“溶けた鋼の海”に沈む アーノルド・シュワルツェネッガー氏が提案 米企業が動画公開
-
4
「AIを使えば早くできるでしょ」と言われがち――エンジニアを困らせる"勘違い"の正体とは?
-
5
「まず、その業務なくせない?」 野村不動産HDが経理DXで「年間9000時間」を生み出した“引き算”の考え方
-
6
国産AI「LLM-jp-4」ベースのAIモデル、KDDI傘下のELYZAが無料公開
-
7
Rails作者DHH「Pencils Down、もう手でコードは書かない」 それでもソフトウェア開発の未来は明るい理由
-
8
Autodesk、FusionなどのAI機能を発表 設計作業の自動化や設計資産の再利用を支援
-
9
「DMに逃げる理由は秘密保持ではない」 人とAIエージェントの“最強チーム”を作るベストプラクティス
-
10
「システムプロンプト陳腐化」をどう防ぐか AWSの試行錯誤に見る「自社AIエージェント」運用のポイント
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR