




















少ない学習データでも高精度で文字認識 富士通が開発、ディープラーニングを効率化
中国の富士通研究開発中心(FRDC)は2月21日、古文書文字を画像認識するディープラーニングに改良を加え、少ない数の学習データでも高精度で認識できる仕組みを開発したと発表した。従来技術と比べると、1文字当たり約70%少ないデータ数で同じ精度を実現でき、古文書文字を電子化する作業の効率化につながるという。
ディープラーニングを用いた従来の文字認識では、あらかじめ文字画像と正解の文字を正しくひも付けたデータを認識エンジンに学習させる。学習するデータが多いほど認識精度は高くなるが、中国の古文書文字だとさまざまな書体がある上に、同じ文字でも字形が異なる場合もあり、十分な量の学習データを用意することが難しかった。
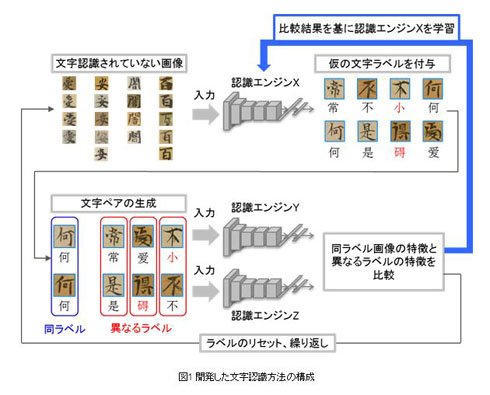 新技術の仕組み
新技術では、これまでは正解の文字とひも付かずに学習データに使われていなかった文字画像データも学習に活用。(1)認識エンジンが文字画像に、正解と考えられる「仮の文字ラベル」を与える、(2)それらの文字画像をランダムで2枚ずつペアにする、(3)2枚が同じ文字かどうかを別の認識エンジンが判断、(4)判断結果を認識エンジンにフィードバックして違いを学習させる――という手順を繰り返すことで、認識精度を向上させるという。
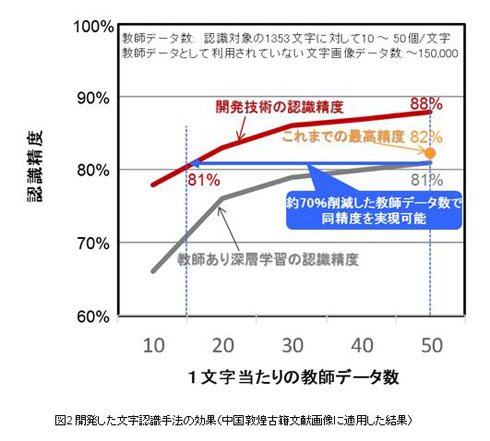
同社のベンチマークテストによれば、新技術は81%の認識精度を達成するのに必要な学習データの数(1文字当たり)が、従来技術よりも約70%少なくて済むという。1文字当たり50個のデータを使って学習させた場合は、従来技術だと約82%だった認識率が、新技術では88%まで向上したという。
新技術は、中国各地の図書館や古文書データベース向けに提供する予定。日本語や韓国語などにも応用できるという。2018年度には富士通の人工知能(AI)技術「Human Centric AI Zinrai」への活用を目指し、植物の識別など、認識すべき対象が多い用途に導入するとしている。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
4
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
-
5
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
6
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
7
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
-
8
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
9
「若手はAI使うな」は“老害”なのか? 新人教育で「AI禁止」した企業の1年後
-
10
グッスマに不正アクセス、公式EC閉鎖 会員の住所や注文履歴など漏えいか 再開目処立たず
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR