




















日本語に強い大規模言語モデル「Swallow」 産総研と東工大が公開 事前学習用の日本語データに工夫
産業技術総合研究所と東京工業大学の研究チームは12月19日、日本語に強い大規模言語モデル(LLM)「Swallow」を公開した。米Metaが開発したLLM「Llama 2シリーズ」をベースに日本語能力を改善させたもの。ライセンスは「LLAMA 2 Community License」で、研究や商業目的で利用できる。
 日本語に強い大規模言語モデル「Swallow」
今回公開したのは、パラメータ数が70億(7B)、130億(13B)、700億(70B)のモデル3種類。Llama 2シリーズが持つ高い言語処理能力を維持しながら日本語能力を強化することを目指した。
このため、AIモデルに日本語の文字や単語などの語彙を追加し、新たに開発した日本語データで継続事前学習(学習済みのLLMに対して追加で事前学習を行う手法で、異なる言語などで言語モデルを活用するときに使われる)を行った。結果、日本語に関するベンチマークデータで、全モデルがベースモデルよりも高い性能を示したという。
着目したのは日本語データセット
研究チームが今回着目したのは、事前学習に使った日本語データだ。従来の日本語LLMの学習には「CC-100」「mC4」「OSCAR」などの既存のデータセットの日本語部分を使っていた。しかし、これにはWebページのHTMLをテキスト化する際のノイズが混入したり、最新の情報や知識を収録していなかったりする問題があった。また、もともと多言語のデータセットであるため、日本語に特化してデータの品質を高める工夫がなかった。
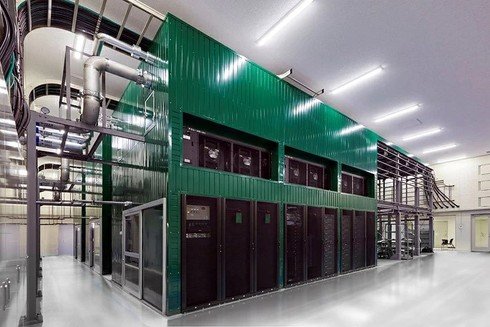 産総研の「AI橋渡しクラウド」(ABCI)
そこで研究チームは、Webサイトを収集してアーカイブを無償公開している非営利団体「Common Crawl」が配布しているアーカイブ(2020~2023年に収集した約634億ページ)から日本語のテキストを独自に抽出・精錬し、約3121億文字(約1.73億ページ)からなる日本語のデータベース(コーパス)を構築した。これは商用利用が可能なものとしては最大規模であるという。
研究チームは「今回のモデル公開によって、高度な日本語処理が求められる日常生活・産業現場のより多くの場面で、対話システムなどのAI技術の利活用を推進できる」と成果を説明。日本でのLLMの研究開発・活用がさらに進み、製品開発や技術革新が進むことを期待している。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
4
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
5
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
-
6
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
7
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
8
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
-
9
GMO、攻撃者による情報公開を確認 顧客データ含むか調査中 追加の見舞金も検討
-
10
タイムズカー、お見舞金3000円の算定基準は? パーク24に聞いた
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR