


Sakana AI、複数の画像を扱える“日本語視覚言語モデル”公開 非英語圏での先駆けに
AIスタートアップのSakana AI(東京都港区)は8月2日、複数の画像について日本語で質疑応答できるAIモデル「Llama-3-EvoVLM-JP-v2」を発表した。このモデルは、同社が提案する生成AIの開発手法「進化的モデルマージ」で開発した視覚言語モデル(VLM)。作成したAIモデルなどはHugging Faceで公開中。
 Sakana AI、複数の画像を扱える“日本語視覚言語モデル”公開
「Llama-3-EvoVLM-JP-v2」の特徴は、複数の画像を扱えること、日本語で応答できることだ。例えばこのAIモデルに、2枚の犬の画像を見せて「それぞれを簡単に説明してください」と質問すると、犬種や身に着けている装飾品など、質問に対する回答を日本語で返してくれる。米Metaが公開しているAIモデル「Llama-3」をベースにしており、同社が過去に公開したAIモデルよりも性能が向上しているという。
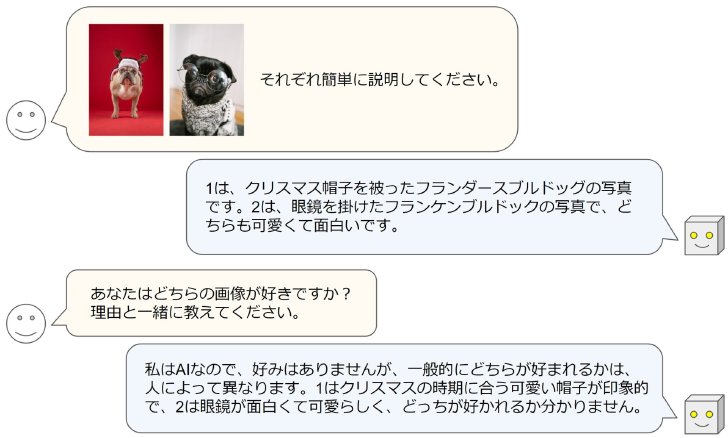 複数の画像について日本語で適切に応答してくれる例
これまでも、画像に対する説明や質疑応答のできるVLMが多く公開されてきた。しかし、そのほとんどが英語圏で開発されたもので、非英語圏で複数の画像を扱えるAIモデルは少ないという。そこで同社は、進化的モデルマージというAI開発手法で、日本語VLMの構築に挑んだ。
この手法は、複数の基盤モデル(大規模なデータセットによる事前学習で各種タスクに対応できるモデル)を組み合わせ、それぞれの特徴を併せ持つ新たなモデルを作るというもの。今回のケースでは「複数の画像を扱える英語のVLM」と「日本語の能力に長けた大規模言語モデル」「1枚の画像の説明能力に長けたVLM」の3つのモデルを使って「高性能な複数の画像を扱える日本語のVLM」を生み出すことに成功したという。
Sakana AIは開発したVLMの性能を評価するため、新たな評価用データセット「JA-Multi-Image-VQA」を作成。結果、モデルマージのベースに使ったVLM(Mantis-8B-SigLIP)よりも高いスコアを記録し、性能が上がっていることを示した。このデータセットや、Web上で試せるデモページなどもHugging Face上で公開している。
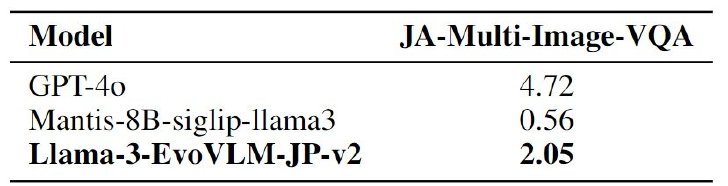 ベースに使ったVLMの約4倍のスコアを記録している「Llama-3-EvoVLM-JP-v2」
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
引退した人型ロボ、“溶けた鋼の海”に沈む アーノルド・シュワルツェネッガー氏が提案 米企業が動画公開
-
2
「FDE」は常駐SEのすげ替えなのか “人月商売の死”を打破したい国内SIer、打開策は意外なところに?
-
3
総額2.3兆円、千葉市に巨大な「AIデータセンター」建設へ 発電大手JERA参画の“ドリームチーム”、勝機どうつかむ?
-
4
Google、「Gemini 4 Pro」ではなく「Gemini 4 Argon」発表 まずはサイバー防御組織に限定提供、出力上限は100万トークンに
-
5
ChatGPTにAIでバーチャル試着機能とカメラでの書類スキャン→PDF化機能
-
6
農水省の“クソダサ”ポスター話題 「AIよりよっぽど良い」の声も 担当者に狙いを聞いた
-
7
人間は「取締役2人だけ」 実務をAIが担う新会社、セキュリティサービスのHENNGE
-
8
「まず、その業務なくせない?」 野村不動産HDが経理DXで「年間9000時間」を生み出した“引き算”の考え方
-
9
「AIを使えば早くできるでしょ」と言われがち――エンジニアを困らせる"勘違い"の正体とは?
-
10
Rails作者DHH「Pencils Down、もう手でコードは書かない」 それでもソフトウェア開発の未来は明るい理由
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR