




















MIT、人種差別的と批判された大規模画像データセット「Tiny Images」をオフラインに
米マサチューセッツ工科大学(MIT)は6月29日(現地時間)、多数のAIシステムのトレーニングに利用されてきた8000万点以上の画像を集めたデータセット「Tiny Images」をオフラインにしたと発表した。カテゴライズの用語に差別的なものがあると指摘されたため。
MITのアントニオ・トラルバ教授は声明文で、「影響を受けた可能性のある人々に謝罪する」と語った。
問題を指摘したのはプライバシー関連の米新興企業UnifyIDのチーフサイエンティスト、ビナイ・プラブー氏とアイルランド国立大学ダブリン校のアベバ・ビルハネ教授。両氏は6月25日、「Large image datasets: A pyrrhic win for computer vision?」(リンク先はPDF)という匿名の論文(7月1日に正式版を公開)で、Tiny Imagesに女性の画像に「売春婦」というラベルが付いていたり、黒人の画像に黒人の蔑称のラベルが付いていたりする例を具体的に挙げた。
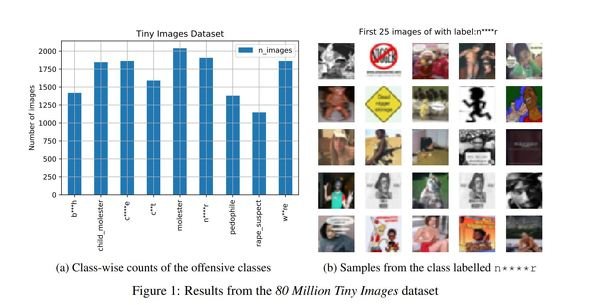 データセット内の問題のあるラベルのついた画像の例(論文より)
トラルバ教授は、修正するにはデータセットが大きすぎ、画像が32×32ピクセルと非常に小さいため、手作業による修正は困難と判断し、完全にオフラインにする決定を下したと説明した。
このデータセットは2006年に作成された。その際、プリンストン大学認知科学研究所のWordnetからコピーした5万3464語の名詞をラベルとして使い、これらの用語に対応する画像を検索エンジンを使って自動ダウンロードし、8000万件の画像を収集したという。
このデータセットを使ってトレーニングしたニューラルネットワークは当然、データセットで使われているラベルを使うことになる。
問題を指摘したプラブー氏とビルハネ教授は論文で、この問題は社会的および文化的構造に深く根ざしており、簡単な解決策はないと指摘。Tiny Imageだけでなく、広く利用されているデータセット「ImageNet」にも同様の問題があるという。だが、解決のために例えばバイアスを完全に取り除くという考えは、単に問題を隠すことに繋がるとしている。「機械学習コミュニティが、社会的弱者への影響に細心の注意を払うことを強く推奨する。そのためには、歴史的前例、コンテキスト、政治的側面の認識が不可欠だ。この論文が意識向上に貢献し、機会学習における倫理と正義についての議論に役立つことを願う」
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
4
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
5
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
-
6
GMO、攻撃者による情報公開を確認 顧客データ含むか調査中 追加の見舞金も検討
-
7
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
8
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
9
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
10
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR