




















Meta、音声生成AIモデル「Voicebox」発表 ノイズ除去や言い間違い修正、多言語会話など多機能
米Metaは6月16日(現地時間)、新たな音声生成AIモデル「Voicebox」を開発したと発表した。音声の編集、サンプリング、スタイルの設定などを行える。
音声とテキストを入力することで、以下のような音声を出力できる。
- 入力した声で入力したテキストを読み上げる音声クリップを作成する
- 録音した音声から犬の鳴き声やブザー音などのノイズを除去する
- 録音した音声の言い間違いを修正する
- 1つの言語のスピーチを同じ声のまま別の言語に変換する(英語の音声を仏語に、など)
- 1つのテキストを多様な声で読み上げる
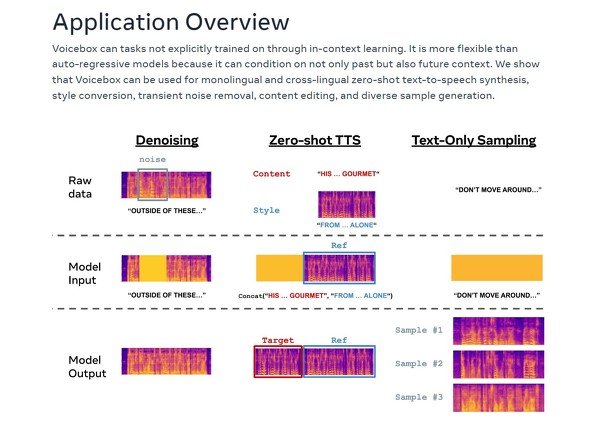 アプリケーションの概要
Metaは、Voiceboxで将来的にはメタバース内のバーチャルアシスタントやNPC(ノンプレイヤーキャラクター)が自然な声で話せるようになるとしている。また、自分の声のまま(本来は話せない)外国語で会話したり、映画の吹き替えも声優ではなく本人の声で行えるようになるという。
Voiceboxは、「非自己回帰フローマッチングモデル」に基づく音声生成モデル。大規模データを使ってテキストによる音声入力タスクの解決方法を学習することで、コンテキスト内学習を通じて音声タスク全体で単一目的のAIモデルよりも優れたパフォーマンスを発揮するとMetaは説明する。
トレーニングには、英語、フランス語、スペイン語、ドイツ語、ポーランド語、ポルトガル語によるパブリックドメインのオーディオブックの音声とそのトランスクリプト、5万時間分を使った。
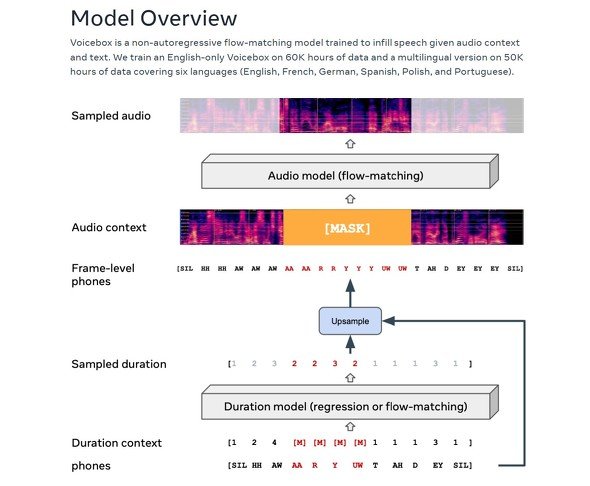 非自己回帰フローマッチングモデル
Metaは、非自己回帰フローマッチングモデルは、「最先端の自己回帰モデルのTTSより最大20倍の速度で音声を生成する」としている。例として、米Microsoftの「VALL-E」を挙げた。
Metaは論文やサンプル集は公開したが、アプリやソースコードは公開していない。「他の強力な新しいAIイノベーションと同様、このテクノロジーが誤用や意図しない危害をもたらす可能性があることを認識している」からだ。「AIの最先端を前進させるために研究を共有することが重要であると信じているが、オープンさと責任の間の適切なバランスをとることも必要」としている。
TTSの悪用は既に問題になっている。最近ではドレイクとザ・ウィークエンドの声を無断で使った生成型AI楽曲がSpotifyで公開され、話題になった。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
GMO、不正アクセス実行犯の手がかりに懸賞金 1億5000万円規模
-
4
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
5
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
6
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
7
IPO目論見書に「AIは人類の存亡リスク」「コードの9割はClaude製」 Anthropicが示した規格外の見立て
-
8
Google DeepMind、ワールドモデル「Genie 4」発表 音声や会話もリアルタイム生成、Geminiと連携
-
9
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
10
So-net、会員情報約259万件が漏えい 一部メールサービスではパスワードも流出
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR