




















Google DeepMind、ロボットの行動を改善する新VLAモデル「RT-2」発表
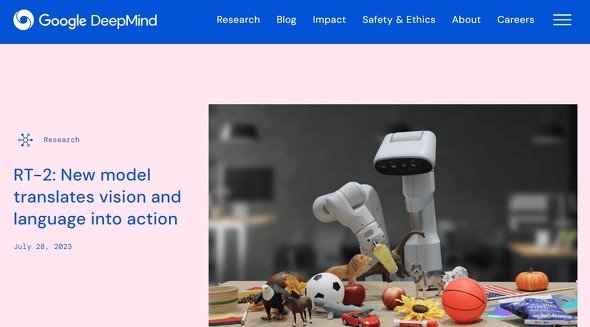
米Google傘下のGoogle DeepMindは7月28日(現地時間)、視覚と言語を行動に翻訳する新しいVLA(Vision-Language-Action)モデル「RT-2」を発表した。
RT-2 は、Web上のテキストと画像でトレーニングされたTransformerベースのモデルで、ロボットのアクションを直接出力できる。LLM(大規模言語モデル)をWeb上のテキストデータでトレーニングするのと同様に、RT-2はWeb上のデータから知識を転送してロボットの動作に情報を与える。
これにより、従来は例えば「コーラの空き缶をゴミ箱に捨てて」という命令を実行するためには、コーラの缶とはなにか、それが空になっていることはどうやって判断するか、物体を掴むにはどうすればいいのか、ゴミ箱とはなにか、ゴミ箱に捨てるというアクションはどういうものか、など、膨大な定義をロボットに教える必要があったところ、初めてコーラの空き缶を見ても、それがコーラの空き缶だと認識でき、「捨てる」というアクションの意味も理解するようになる。
Google DeepMindのロボティクス責任者、ヴィンセント・ヴァンホーク博士は「RT-2はWebデータの大規模なコーパスから知識を転送できるため、ゴミが何であるかを理解しており、明示的なトレーニングなしで識別できる」と説明する。「ポテトチップスの袋やバナナは、食べた後にゴミになる。RT-2は視覚言語トレーニングデータからそれを理解できる」。
デモでは、「バナナをドイツの国旗の上に置いて」「コーラの缶をテイラー・スウィフトの肖像の近くに移動して」「イチゴをイチゴが入っているボールに入れて」などの命令を実行させている。国旗やテイラー・スウィフトについてはWeb上の画像から学習したのだろう。
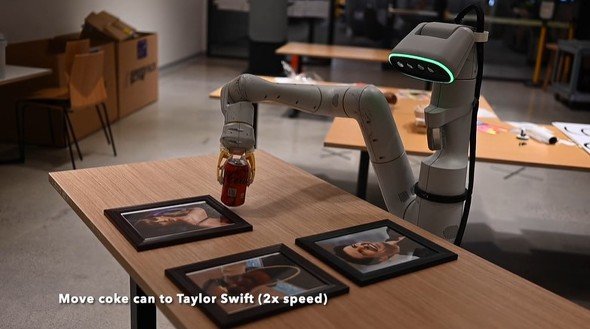 テイラー・スウィフトを認識した
モデル名から分かるように、RT-2には先代にあたるRT-1があった。2022年12月に発表したRT-1は、ロボットが自分の経験から学習し、それを他のロボットと共有できるようにする相互に学習できるようにするロボティクストランスフォーマー(RT)モデルだった。
RT-2モデルをテストした結果、新しいタスクの実行効率はRT-1は32%だったところ、RT-2は62%に向上したという。「RT-2を使えば、ロボットは人間と同じようにさらに学習することができ、学習した概念を新しい状況で使うことができる」とヴァンホーク氏は語った。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
GMO、不正アクセス実行犯の手がかりに懸賞金 1億5000万円規模
-
4
GMO不正アクセスの犯人サイト、ドメイン停止を確認
-
5
資さんうどん、従業員の退職理由などが外部から閲覧可能に 委託先の勤怠システムに設定不備
-
6
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
7
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
8
So-net、会員情報約259万件が漏えい 一部メールサービスではパスワードも流出
-
9
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
10
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR