




















なぜ日本はGPUのない「富岳」でLLMを研究するのか 外国に後れを取らないための“現実的な理由”(1/2 ページ)
米OpenAIの大規模言語モデル(LLM)・GPT-4は今、世界を大きく塗り替え続けている技術の一つだ。世界各国の企業がこぞってLLMの開発を進めている。特にGAFAなどの巨大企業は、その膨大な資源を使ってすでにいくつものLLMを世に放っている。
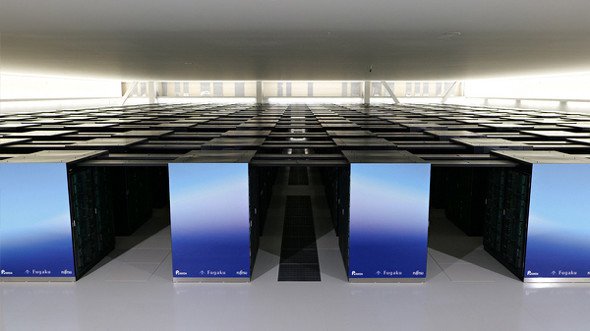 富岳
そんな中、日本では理化学研究所と富士通、東京工業大学、東北大学が、スーパーコンピュータ「富岳」を使ったLLMの研究を今まさに進めている。学習手法の研究からデータの法的な扱いまで幅広く検討し、日本のLLM開発の基盤を作るのが目的だ。
深層学習といえば、今ではGPUを使うのが一般的になっている。しかし富岳はそのGPUを搭載していない。日本にはGPU搭載スパコンも存在するのに、なぜ富岳を使ってLLMを研究するのか。
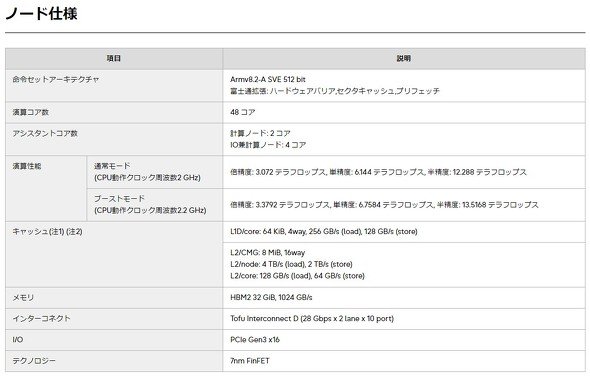 富岳にGPUは載っていない
今回は富士通研究所・コンピューティング研究所の中島耕太所長と白幡晃一さんに、富岳を使ったLLM研究について、その意義を聞いた。富岳は確かにハイスペックなスーパーコンピュータだ。しかし、LLM研究における活用には、それだけでないもっと“現実的な理由”があった。
やりたいのは10の23乗規模の計算 それができるのは?
LLMの学習には大量の計算が必要になる。では、具体的には何回以上計算すればいいのか。これには一つの答えがあるという。
その数字が「10の23乗FLOPs」だ。富岳をはじめとするスーパーコンピュータの性能を示すとき「このスパコンの計算速度は○○FLOPsです」のようにいうことがあるが、今回の「FLOPs」は計算速度ではなく計算量を示す単位のこと。平易に書くなら「10の23乗回」となる。10の23乗は日本語でいうと「1000垓」。1兆の1000億倍のことだ。
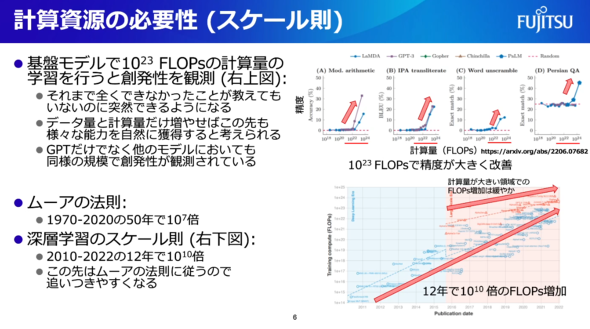 計算回数が10の23乗回周辺になると急激に性能が上がる(右上)
中島さんによると、過去の研究の中でLLMには不思議な性質が見つかっているという。LLMの学習を進めていると、しばらくはあまり派手な性能向上が見られないのだが、ある時点でなぜか急に能力が跳ね上がり、それまでできていなかったような処理をできるようになる──それが10の23乗FLOPsだ。
つまり、LLMを開発するならスーパーコンピュータに1000垓回分の計算をさせることが一つの目標になる。
「この“急に”ということはある程度重要で、小さな計算量では意味がないということを逆に示している。米OpenAIのLLMのパラメーター数を見てみると、これまでにずいぶんと増えている。賢さを得るために相当に計算量を増やしているのは間違いない」(中島さん)
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
4
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
5
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
-
6
GMO、攻撃者による情報公開を確認 顧客データ含むか調査中 追加の見舞金も検討
-
7
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
8
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
9
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
10
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR