




















なぜ日本はGPUのない「富岳」でLLMを研究するのか 外国に後れを取らないための“現実的な理由”(2/2 ページ)
GPUスパコンがあるのに非GPUスパコンの富岳を使う意味
一方で、1000垓規模の計算をするにあたっては、富岳以外の選択肢もある。一般的に深層学習に向いているとされるGPUを搭載したスーパーコンピュータとしては、産業技術総合研究所が構築・運用する「ABCIシステム」が日本最大とされてきた。搭載されているGPUの計算処理性能も富岳のCPUを超えている。
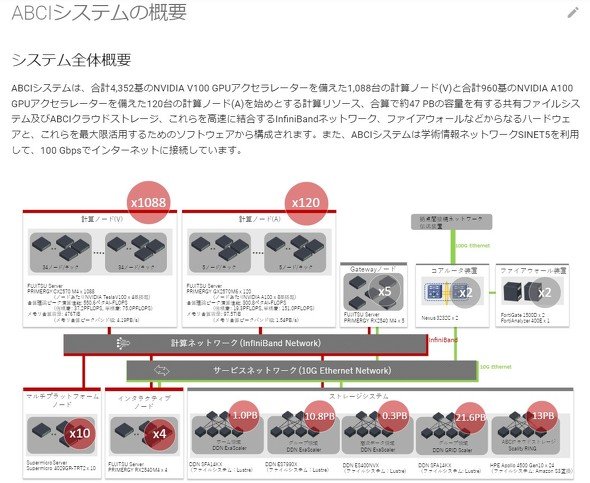
富士通研究所の白幡さんによると、ABCIシステムを完全に貸し切って10日ほど計算させれば、1000垓規模の計算をすることも「技術的には可能」(白幡さん)という。
しかし、現実的にはそうもいかない。ABCIシステムはさまざまな組織が共用しているものであり、長時間貸切ることが難しい。性能は高いが占有できないという“現実”がハードルになっている。
対して富岳は、各CPUの処理性能を見るとABCIシステムのGPUの17.75分の1程度。しかし、現実的に使えるリソースの規模を考慮すると1000垓規模の計算を実現できるのは日本で富岳だけになるという。
この1年を無駄にしないための富岳 「勝負の年」
LLMの研究分野は非常に流れが速く、短期間でどんどん更新されてしまう。それも富岳でLLMを研究する意味の一つという。
「24年度以降になれば、また使えるサービスも増えてくるため、それも活用するべきだと思うが、それは未来の話。LLMの研究は半年前と今では状況が全く違う。1年間放っておくわけにはいかない。23年度がある意味勝負と考えている。23年度でどこまでできるかが24年度につながっていく」(白幡さん)
今はさくらインターネットが8月上旬にクラウドサービス「さくらのクラウド」で、AI開発・研究向けの新プラン「コア専有プラン(AMD EPYC 7003 Series Processor)」を公開している。同社はGPUクラウドサービスへの投資計画を前倒しで進めるとも発表しており、24年度には確かにLLM研究基盤がさらに充実しそうだ。
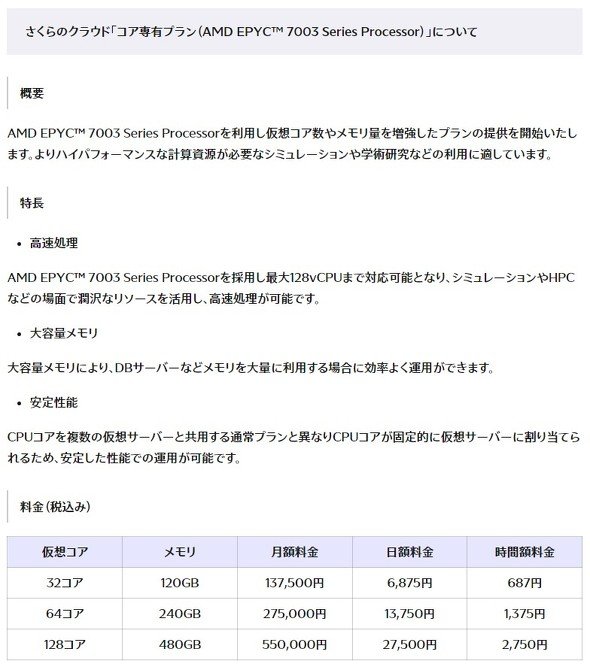 さくらインターネットの「コア専有プラン(AMD EPYC 7003 Series Processor)」
しかし、それを待っていてはその間に諸外国と差をつけられてしまうかもしれない。その穴を埋めてくれるのが富岳なのだ。
研究チームは計算処理の高速化をはじめ、学習方法を模索していく。開発したLLMは最終的にGitHubやHugging Faceで公開するが、モデルの制作が最終目標なのではない。学習ノウハウという基盤を作ることが目標といえる。それがさくらインターネットなどが公開していく計算資源を上手に使うときにも役立っていくかもしれない。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
2
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
-
3
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
4
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
5
グッスマに不正アクセス、公式EC閉鎖 会員の住所や注文履歴など漏えいか 再開目処立たず
-
6
ジョーシンへの不正アクセス、最大623万件漏えいか 運転免許証2件・マイナカード1件なども
-
7
野村総研、サイバー攻撃時の「能動的なシステム停止」を支援する新サービス
-
8
タイムズカー流出で顧客らが損害賠償求め運営会社提訴へ サイト開設の弁護士が記者会見
-
9
Xの「いいね」長押しで1ドル送金 マスク氏が“投げ銭”機能を予告
-
10
「漏えい」の一言で素通り客が振り返る──相次ぐ情報流出の中で開幕のセキュリティ展示会 来場者の態度も激変
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR