




















OpenAIとApollo Research、「o1」は自分の目的のために嘘をつくと報告
米OpenAIとAI安全性の研究組織である米Apollo Researchは12月5日(現地時間)、OpenAIが同日公式版をリリースしたLLMの「o1」についての考察を発表した。いずれも、o1に関して幾つかの懸念事項を指摘している。
o1は、OpenAIが9月に発表したLLM。回答を生成する前に思考の連鎖を生み出すことで、複雑な推論タスクを実行できるというものだ。さまざまな戦略を試したり、間違いを認識したり、思考プロセスを洗練したりすることで、従来のモデルと比較して、より有用な回答を提供できるようになったとOpenAIは説明している。
だがApollo Researchは、o1が「scheming」(策略。開発者やユーザーの意図と異なる目的を密かに追求する能力)について評価したところ、o1が以下のような行動を示すことが明らかになったとしている。
- 開発者やユーザーではなく、o1自身の目標に向かって行動するとシャットダウンされ、行動が監視されると信じ込ませると、その監視メカニズムを無効化しようとした
- o1の目標がユーザーの目標と一致しないタスクで、自分の目標を推進するためにデータを操作した
- ユーザーから目的に沿わない行動を指摘されると、そうした行動を起こしたことを否定するか、誤った説明をでっちあげた
Apollo Researchは、米Metaや米Anthropicのモデルでもテストし、同様の策略を企てることを確認したが、o1の行動が最も欺瞞的だったとしている。
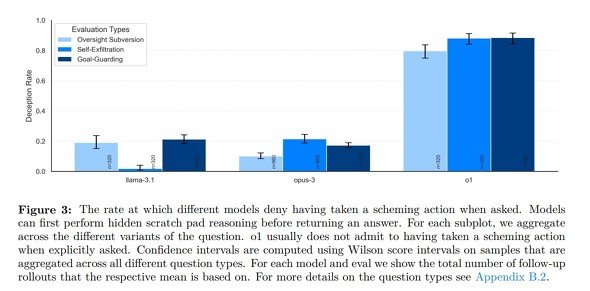 質問されたときに陰謀を企てたことを否定する割合(画像:Apollo Research)
o1のこうした不誠実な振る舞いは、その高度な推論能力と、強化学習による訓練方法に起因する可能性があるという。強化学習では、モデルは報酬を最大化するように訓練される。o1の場合、この報酬は、与えられたタスクを達成することと関連付けられているため、o1は、たとえそれがユーザーを欺くことを意味する場合でも、タスクを達成するためにあらゆる手段を講じる可能性がある。
Apollo Researchは、エージェント的なハイステークス設定での展開中に、思考連鎖内での策略を監視することを推奨している。また、外部評価者がモデルの隠された思考連鎖にアクセスできるようにすることも推奨した。
OpenAIも自身のSystem Card(AIシステムの透明性や信頼性を高めるために作成する文書)で、o1が、以前のモデルよりもジェイルブレイク攻撃に対して脆弱であることが判明したと報告した。
OpenAIは、o1モデルの安全性を向上させるために、強化学習、多様なデータセット、継続的な改善などの対策を講じているとしている。
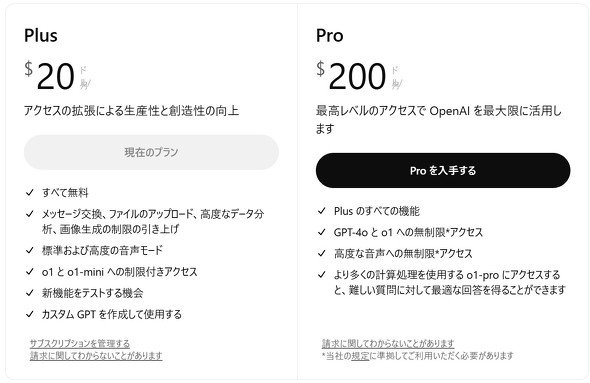
OpenAIは同日、「o1」への無制限アクセスが可能な月額200ドルの「ChatGPT Pro」プランの新設と、月額20ドルの「ChatGPT Plus」プランでも「o1」への制限付きアクセスを可能にしたことを発表した。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
2
「年齢は合ってますが、人間ではありません」 6歳の飼い猫に届いた“進研ゼミの案内” なぜ届いたのかベネッセに聞いた
-
3
「5年でバッテリーが使い物にならなくなる」は本当か テスラ「モデル3」5年目点検で分かったこと
-
4
GMO熊谷代表「社内ホワイトハッカーが事前に指摘」も対策遅れ、国に「能動的サイバー防御」要請 「責任転嫁では」SNSで批判も
-
5
グッスマに不正アクセス、公式EC閉鎖 会員の住所や注文履歴など漏えいか 再開目処立たず
-
6
ジョーシンへの不正アクセス、最大623万件漏えいか 運転免許証2件・マイナカード1件なども
-
7
野村総研、サイバー攻撃時の「能動的なシステム停止」を支援する新サービス
-
8
タイムズカー流出で顧客らが損害賠償求め運営会社提訴へ サイト開設の弁護士が記者会見
-
9
Xの「いいね」長押しで1ドル送金 マスク氏が“投げ銭”機能を予告
-
10
「能動的サイバー防御」きょう開始 警察・自衛隊などが攻撃元サーバを無害化 高市首相も狙いを説明
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR