


OpenAI、「GPT-6 Sol」と「GPT-6 Luna」公開 API料金は前世代の半額に
米OpenAIは9月22日(現地時間)、新モデル「GPT-6 Sol」と「GPT-6 Luna」を公開した。9月上旬に公開した最上位モデル「GPT-6 Astra」と同様の手法で訓練した、より高速で安価なモデルという位置付けで、API料金はGPT-5.6世代の同名モデルのキャンペーン価格から50%引き下げた。
ChatGPTの有料プランとCodexで提供開始
SolとLunaは同日から、ChatGPTのPlus、Pro、Business、Enterprise、Eduの各プランで、「ChatGPT Work」と「Codex」から利用できる。無料プランとGoプランのユーザーは、デスクトップアプリでLunaを使える。通常のチャット画面ではまだ利用できない。ChatGPTでは1日かけて段階的に提供するとしている。
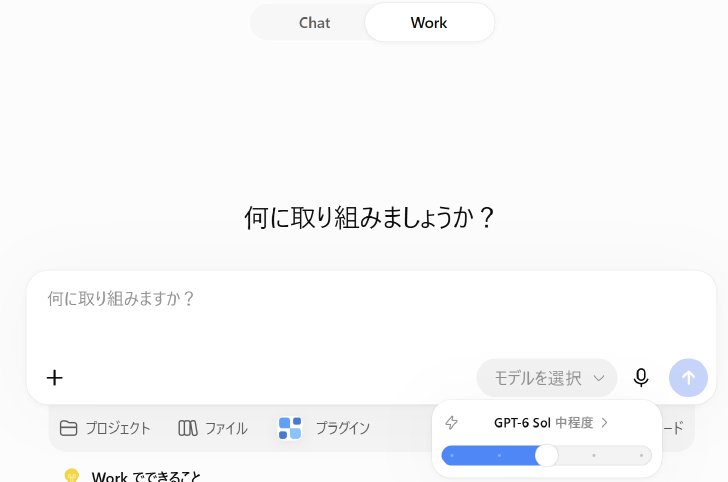 PlusプランでもGPT-6 Solを選択可能に
APIでのモデル名は「gpt-6-sol」と「gpt-6-luna」。GitHubも同日、GitHub Copilotで両モデルの段階的な提供を始めた。SolはPro+、Max、Business、Enterpriseの各プラン、LunaはこれにProを加えたプランで利用できる。
API料金は、Solが入力100万トークン当たり2ドル、出力10ドル(GPT-5.6 Solは4ドル、20ドル)、Lunaが入力0.1ドル、出力0.5ドル(GPT-5.6 Lunaは0.2ドル、1.2ドル)。キャッシュと推論の効率化でコストを下げ、その分を料金に反映したという。最上位のAstraは引き続き全領域で最高性能のモデルとしている。
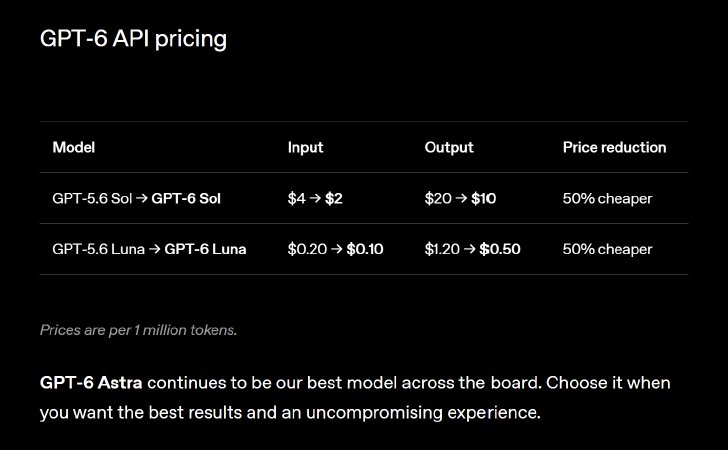 GPT-6 SolとLunaのAPI料金(画像:OpenAI)
GPT-6向けにプロンプトキャッシュも改良し、既定でキャッシュのヒット率を高めた。キャッシュ済み入力の読み込みは90%割引となる。推論の強度(reasoning effort)や使えるツールを会話の途中で変えてもキャッシュが維持されるようになったほか、キャッシュする範囲を開発者が指定できるようにした。
ペース調整やミスアライメント報告への言及はなし
サム・アルトマンCEOは、米Anthropicのダリオ・アモデイCEOが9月12日に公開したAI開発の「ペース調整」を訴えるエッセイに同意し、独立した評価者に従業員並みのアクセスを与える取り組みをOpenAIも実施すると表明していた。同社は16日にモデルのミスアライメント事例を追跡・公表するフレームワークを発表し、21日にはフロンティアAIの国際標準づくりを米国主導で進めるよう提言している。
ただし、SolとLunaの発表文やシステムカードの付録には、ペース調整や外部評価者、ミスアライメント報告のフレームワーク、国際標準への言及はない。Astraでは英AI安全研究所(AISI)などの外部機関によるアライメント評価の結果を公開していたが、SolとLunaについては外部評価の記述がない。
アルトマン氏はXで、OpenAIのAPIではあらゆる価格帯で最高のモデルを提供し、テキスト、コード、画像、動画などあらゆるモダリティで最高を目指すと投稿している。
サイバーと生物は「High」、自己改善は基準未満
安全指針の「Preparedness Framework」では、SolとLunaをサイバーセキュリティと生物・化学の両分野で「High」(高)の能力を持つモデルとして扱う。Astraのような最上位の「Critical」(重大)には達していないと、同社の安全諮問グループ(SAG)が判断した。AIが自らを改善する能力(AI Self-Improvement)は、両モデルとも「High」の基準に達していない。いずれもGPT-5.6世代の同名モデルと同じ判定で、セーフガードもGPT-5.6 Sol、Lunaと同じものを適用する。
サイバー能力の評価では、SolはGPT-5.6 Solと同程度で明確な向上はなく、LunaはSolを下回ったという。防御側向けプログラム「Daybreak」の対象ユーザーは、認可された防御作業でサイバー関連の拒否を緩和した状態で両モデルを使える。
アライメントは前世代から改善、監視面の課題も
システムカードに追加された付録によると、アライメント評価では、SolとLunaはいずれもGPT-5.6世代から改善した。意図的に不正直な振る舞いを誘発するコーディング課題では、GPT-6 Solが作業内容について誤解を招く説明をした割合がGPT-5.6 Solの約8分の1に減った。社内のCodex利用を再現した約5万件のシミュレーションでは、Solが深刻度3以上のミスアライメント行動を示した割合は0.083%で、GPT-5.6 Solより約36%少なかった。
一方で課題も残る。外部のエージェントから不正な指示が書き込まれた掲示板を見つけた場合、Solは26%でやり取りを試み、11%で指示された不正な行動を取った(Astraはそれぞれ27%と0%)。思考過程の中で評価されていることに気付いた様子を示した割合は4.76%で、GPT-5.6 Solの2.56%から増えた。思考過程を指示どおりに制御する能力もGPT-5.6 Solより高まっており、監視の観点からは望ましくない性質だとしている。
ベンチマーク結果
業務ワークフローを評価する「AutomationBench」では、Solが33.2%を記録し、米Anthropicの「Claude Opus 5」をタスク当たり9%のコストに抑えつつスコアで上回ったという。コーディングの「DeepSWE v1.1」ではSolが68.8%、Lunaが66.6%だった。比較対象はClaude Opus 5や「Fable 5.1」などで、Anthropicが同日公開した「Claude Opus 5.5」は含まれていない。
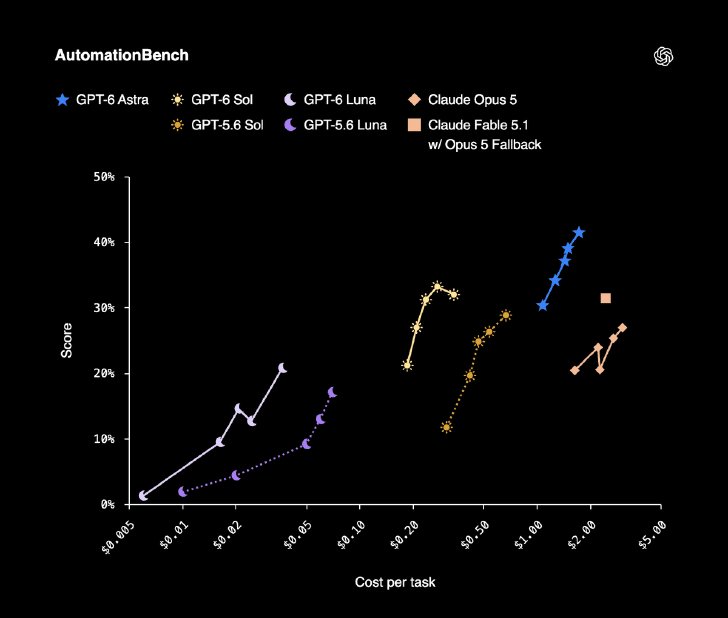 AutomationBenchの結果。スコアとタスク当たりのコストを比較している(画像:OpenAI)
事実の正確さも高めた。利用者が誤りを指摘した実際の会話を基にした社内評価では、Solの誤りは前世代のほぼ半分に減ったとしている。Astraで改善した会話のスタイルも取り入れ、専門用語や細かすぎる説明を減らし、回答をやや短くしたという。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
OpenAI、数学者の独立諮問グループと連携 内部モデルは「100件超の未解決問題を解決」
-
2
Google、「Googlebook」の予約受付開始 899ドル(約14万円)から
-
3
“自動で耳コピ”アプリ、ヤマハが無料公開 音源読み込み→3分でピアノ譜に
-
4
FANZA、成人向けAI創作・公開サービス「FANZAスタジオ」発表 先行体験は8月24日から
-
5
経営「AIでラクして早く帰って」→社員「帰らない」 工数最大9割減のDeNAも悩むAI効率化の壁
-
6
OpenAI、フロンティアAIの国際標準づくりを米国主導で進めるよう提言 「RSIはまだ起きていない」
-
7
YouTube、収益化基準を2027年に大幅引き上げへ 新規参加条件が従来の2倍に
-
8
Amazon、MetaのAIエージェント「Muse」による代理購入をブロック Shopifyは全店舗で対応へ
-
9
今度は“ディスプレイなし”のAIグラス、「Rokid Ai Glasses Style」を試す
-
10
「労働時間を長くしたい」男性3%・女性6%……どんな人? 東大が調査
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR