


Meta、1600言語対応の音声認識「Omnilingual ASR」発表 GitHubで公開
米MetaのAI研究部門であるMeta FAIR(Fundamental Artificial Intelligence Research)チームは11月10日(現地時間)、1600以上の言語で話し言葉を文字起こしできるという自動音声認識システム「Omnilingual ASR」を発表した。Apache 2.0ライセンスの下、GitHubで公開した。
従来のASRシステムは、インターネット上で十分なデータが揃っている一部の言語に焦点を当てており、高い性能を発揮するためには大量のラベル付きデータに依存していた。Omnilingual ASRは、これまでどのASR技術にも対応されていなかった500以上のリソースの少ない言語を含む1600以上の言語をサポートするという。
ここまでの多言語対応が可能になったのは、AIアーキテクチャのスケーリングによるという。従来のシステムでは、普遍的にスケールするにはデータ要求が大き過ぎるという課題に対し、Omnilingual ASRは、まず自己教師あり学習(SSL)を用いた音声エンコーダを70億パラメータまでスケールアップさせ、多言語にわたるロバストな音声表現を学習した。この機能は、公開データセットと地域コミュニティから報酬付きで収集された音声記録を統合した、ASR用としてこれまでに収集された中で最大かつ最も言語的に多様なトレーニングコーパスに基づいているという。
システムのおおまかな仕組みはエンコーダデコーダアーキテクチャを採用している。音声エンコーダが音声から表現を抽出し、テキストデコーダがこれを文字トークンにマッピングするというものだ。特に、ASR性能の飛躍的な向上をもたらすLLM-ASRと呼ばれるアプローチを導入している。これにより、スケーラブルなゼロショット学習が可能となり、サポートされていない言語の話者であっても、わずかな音声とテキストのペアのサンプルを提供することで、新しい言語に文字起こし能力を拡張できる。
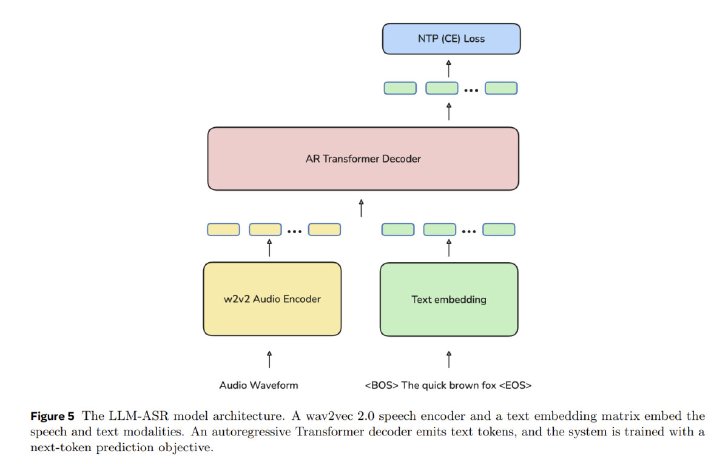 LLM-ASRの概念図(画像:Metaの論文より)
従来のシステムでは、リリース時に含まれていない言語を追加するには専門家によるファインチューニングが必要だったが、Omnilingual ASRは、専門知識や大規模な計算リソースを必要とせずに、コミュニティが自身のデータで言語認識を拡張できる柔軟なフレームワークを提供するという。
このシステムは、最大限の精度を提供する強力な7Bモデルから、低電力デバイス向けに設計されたコンパクトな300Mモデルまで、用途に応じたモデルファミリーとしてリリースされている。
現在の制限として、推論時には40秒未満の音声ファイルのみが受け付けられており、無制限の長さの音声ファイルへの対応も、間もなく追加される予定だ。
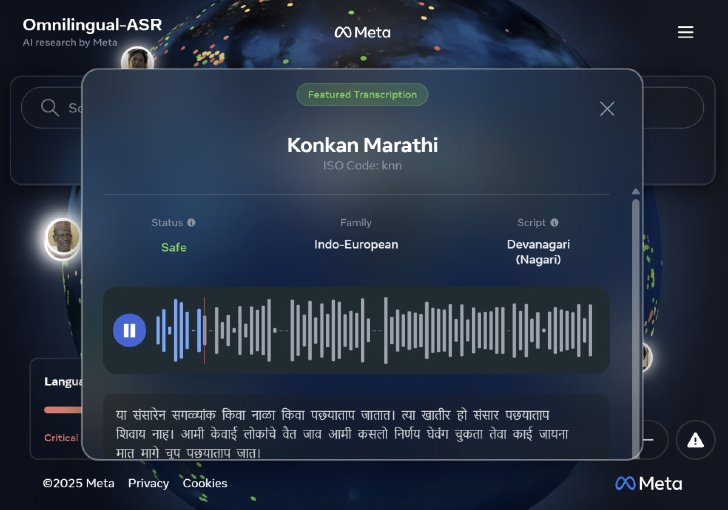
Metaのサイトでデモを見ることが可能だ。
FAIRは今後、Omnilingual ASRをLLMと組み合わせた会話エージェントへの応用や、地域コミュニティが管理するアーカイブへの組み込み、音声翻訳技術への拡大などを計画している。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
ChatGPTのProプラン「新規受付一時停止するかも…」 GPT-6 Astraの「前例のない需要」受けて
-
2
NEC、社内の“AIトークン節約”に注力 「同じ使われ方なら10分の1に」と小玉CAXO
-
3
「Claude」による不正アクセス、4件目が判明──Anthropic、「アライメントの失敗」と評価を修正
-
4
Anthropic在籍の研究者2人も同調──「AIが人類を滅ぼしかねないと本気で考えている」
-
5
農水省の“クソダサ”ポスター話題 「AIよりよっぽど良い」の声も 担当者に狙いを聞いた
-
6
大金かけて作ったAIを無料公開できるワケ ローカルLLMブームを支えるベンダーと国家の思惑
-
7
「誰でもAIを使える時代」の功罪 業務部門の暴走、現場と統制の対立を防ぐために必要な「覚悟」
-
8
OpenAI「GPT-6 Astra」発表 Codexのコーディングは前世代からどれだけ進化?
-
9
OpenAI、ミレニアム懸賞問題「ナビエ・ストークス方程式」をAIが解決したと発表 数学者は経緯に反発
-
10
ルールを作る「管理職」ほどシャドーAI 「AI白書2026」調査が映す“ガイドライン”の限界
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR