


「Transformerの最大475倍」 富士通、GPUを効率的に使うLLMアーキテクチャ「PHOTON」開発
富士通は6月24日、大規模言語モデル(LLM)を少ないGPUで動かせる新アーキテクチャ「PHOTON」(フォトン)を開発したと発表した。GPU当たりの処理性能(スループット)が、現在のLLMで主流のアーキテクチャ「Transformer」の最大475倍に達するという。LLMの運用に必要なGPUを抑え、大幅なコスト削減につなげられるとしている。
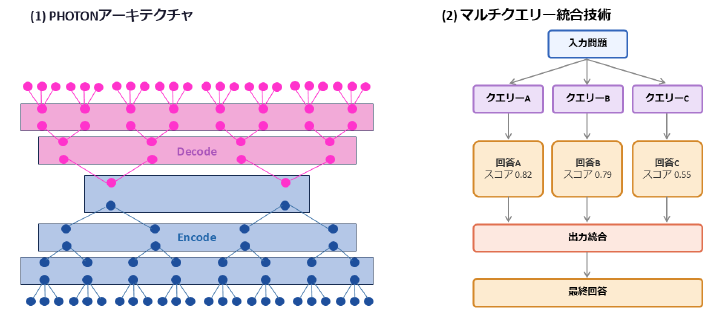 GPU当たりの処理性能がTransformerに比べ最大475倍という、富士通のLLMアーキテクチャ「PHOTON」
「PHOTON」は「Parallel Hierarchical Operation for TOp-down Networks」(トップダウンネットワークのための並列階層オペレーション)の略。複数の入出力をやりとりするマルチエージェントのような処理を、低コストで効率よくこなせるのが特徴という。
近年のLLMは、推論時に長く・多く“考えさせる”ほど性能が上がることが分かってきており、長文を扱う場面や、多数のユーザーが同時に利用する場面が増えている。一方で、こうした処理は過去のやりとりを保持するためのメモリアクセスが増え、処理速度が落ちやすい。
PHOTONはこの課題を2つの仕組みで解決するとしている。
一つは、文章を“意味のまとまり”単位で階層的に処理する点だ。Transformerは文章を「トークン」(数文字程度の単位。概ね単語)に分解し、トークン同士の関係をすべて計算する。PHOTONは、文章を意味のかたまりとして捉えて階層的に処理することで計算量を抑える。複数の文章をまとめて扱うことで、GPU当たり最大475倍の計算効率を発揮するという。
もう一つが「マルチクエリー統合技術」だ。同じ問題に対し、少しずつ異なる複数の問いや回答候補を作り、多数決や最良の候補を選ぶ形で結果を束ねる。これにより、1回の推論でより安定した高い性能を得られるとしている。
実験では、6億・9億・12億パラメータの3種類のモデルで、Transformerよりメモリ使用量を抑えつつ高いスループットを達成。特に12億パラメータのモデルでは、わずかな性能低下と引き換えに、Transformerの約475倍のマルチクエリー処理能力を実現したという。1回の生成に使うKVキャッシュが小さく、同じGPUメモリでも複数の生成を並列に走らせられる点も利点で、検証では9つのクエリーを束ねるだけで従来のTransformerと同水準の性能に届いたとしている。
富士通はこの成果を、7月2日から米サンディエゴで開かれる自然言語処理分野のトップ会議「ACL 2026」のオーラルセッションで発表する予定。
Copyright © ITmedia, Inc. All Rights Reserved.
本記事は制作段階でChatGPT等の生成系AIサービスを利用していますが、文責は編集部に帰属します。


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
京大がAI依存チェックリスト公開 「当てはまるものあれば、しばらくAI触らないで」
-
2
ChatGPT「Plus」プラン一部ユーザーに「dots」解禁 「Business Standard」全ユーザーにも
-
3
「オントロジー」とは結局何なのか Palantir、Databricks、Snowflake、NVIDIAで中身が違う理由
-
4
さよなら「Claude Code」 人気AIに愛想を尽かしたエンジニアの意外な移行先:906th Lap
-
5
伊藤忠が月1.3万時間削減、数千件の「二重業務」解消へ AI推進で経営陣を動かした「定量の匂い」とは?
-
6
なぜ中国はヒューマノイドを量産するのか 突き動かす「焦り」と足踏みの正体
-
7
日立が「フィジカルAI」で狙う“5年で事業規模2倍”の勝算 3.5万人の新会社トップが語る「戦略の2本柱」とは?
-
8
AIモデリングもできる無償3D CAD「SolidCraft」を試してみた!
-
9
「Muse」専用メアド、無料で作成可能に AIが送受信を代理
-
10
孫正義氏が明かす、アンソロピック出資見送りの舞台裏 「僕の失敗」「あん時入れときゃよかった」
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR