




















AWS S3の長時間サービス停止の原因はエンジニアの入力ミス
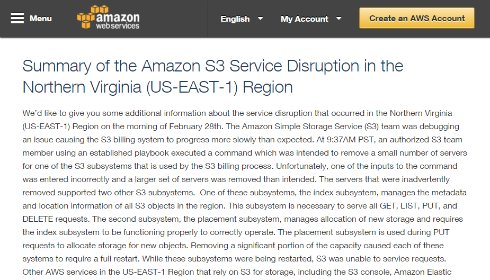
米Amazon.com傘下のAWSは3月2日(米太平洋時間)、2月28日にクラウドストレージサービス「S3」の北バージニアリージョン(US-EAST-1)で起きた大規模なサービス停止の原因と対策を発表した。
28日午前11時20分ごろ発生したこの問題は復旧までに約4時間かかり、同サービスを利用するIFTTT、Quora、Medium、Imgur、GitHubなど、多数のサービスが影響を受けた。
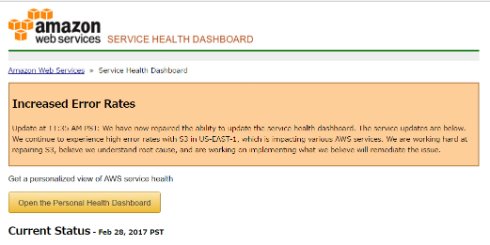 ダウン中のステータス告知
原因は、エンジニアの入力ミスだった。
同日の午前9時37分、S3の課金システムのデバッグ中、S3のサブシステム用の少数のサーバの接続を解除しようとした際、コマンドの入力を誤り、意図したよりも多数のサーバを解除してしまった。その中の2つのサーバが、同リージョン内のすべてのS3オブジェクトのメタデータと位置情報を管理するインデックスサブシステムと、運営にとって重要な配置用サブシステムだったため問題が大きくなった。
問題解決のためにはこれらのサーバを再起動する必要があり、再起動するまでの間、S3でサービスリクエストが受けられなくなっていた。S3 APIも利用できなかったため、EC2、EBS、AWS Lambdaにも影響が及んだ。
S3のサブシステムは、ある程度のサーバ解除では影響が出ないよう設計されているが、ここ数年で利用が急拡大したため、再起動にかかる時間が予想以上に長くなっていたと同社は説明する。
今回の事故を受け、サーバ接続解除だけでなく、システム変更に関わるすべての入力でミスを防ぐようツールを変更した。また、S3の主要サブシステムのリカバリ時間を短縮するための改善も行った。
また、AWSのService Health Dashboard(SHD)もこの問題の影響で正しく表示できなかった(その間公式Twitterアカウントで進捗をツイートしていた)ため、SHDのコンソールを複数のAWSリージョンで稼働するよう変更した。
同社は顧客に謝罪し、今回の事故から学んだことを最大限に生かしてサービスを改善していくと約束した。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
資さんうどん、従業員の退職理由などが外部から閲覧可能に 委託先の勤怠システムに設定不備
-
2
VTuber「兎田ぺこら」グッズにSNSで風評被害→示談成立 「保護者同伴で謝罪などがあったため」
-
3
auメールで朝から障害 全国で利用しづらい状況に
-
4
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
5
GMO不正アクセスの犯人サイト、ドメイン停止を確認
-
6
Anthropic、独自の“創薬活動”に着手 社員1人のバイオ企業を買収、小児難病の治療薬研究を進める
-
7
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
8
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
9
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
10
「対策を後回しにしたサーバが軒並み狙われている」 相次ぐ不正アクセスにラックCTOが警鐘
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR