




















清水亮の「世界を変えるAI」
百花繚乱の大規模言語モデル その現状まとめ【2023年4月末版】(2/3 ページ)
特に注意すべきは、アーキテクチャとデータセットの組み合わせだ。
大規模言語モデルは、基本的にはアーキテクチャとデータセットを組み合わせたものである。ほとんどの大規模言語モデルはTransformerなので、差が出るとすれば、パラメータ数と学習に用いたデータセットになる。
RWKV(ルワクフと読むらしい)は、この表の中では唯一、独自のRNNベースのアーキテクチャをもっており、Transformerに比べると高速でしかも高価なVRAMを必要としないため、コミュニティが活発で期待されているものの1つである。
RWKVにAlpaca Datasetを学習させたRavenは中でも活発に学習されており、毎週のようにバージョンアップされている。
VicunaはWebGPUで動作するバージョンも公開されており、このバージョンのVicunaはWebGPU対応のブラウザがあればローカルで(つまり手元のPCで)動作する。要はNVIDIAの高価なGPUが不要になるわけで、このインパクトはすごい。
いまのところWebGPU対応ブラウザは多くないが、MacならChromeの開発者版であるChrome Canaryで試すことができる。
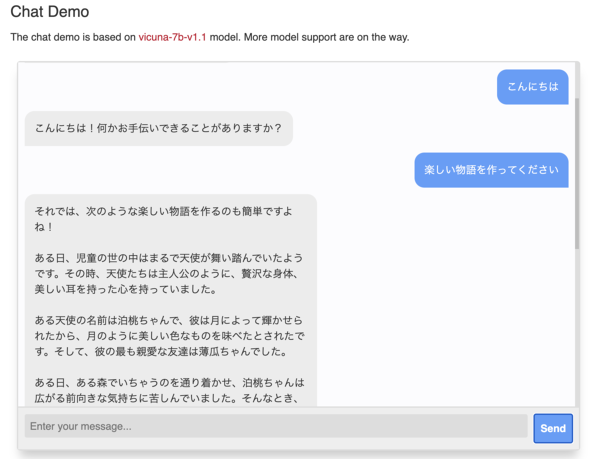 VicunaのWebGPU対応のブラウザによるデモ
限定的ではあるが日本語も使えるし、GPT-4ほどではないが、英語ならGPT-3くらいのことはわずか7B(70億パラメータ)でもできそうな雰囲気がある。
というか、結局は「AIに何を聞きたいか」という人間側の都合の話という気もする。例えばLLaMAはGPT-3の10分の1程度のパラメータ数である13Bで、ほとんどのベンチマークでGPT-3と同等か、それ以上のスコアを達成したと説明されていた。
それはLLaMAが単純にGPT-3を上回っているということを意味するわけではなく、ベンチマークが大規模言語モデルの性能を測る上であまり意味をなさなくなってきていると考えるべきだろう。
例えばGPT-3とGPT-4を比べると、明らかにGPT-4の方が「高度な結果」を返して来るのだが、具体的に何がどのように高度なのか、定量的に説明するのが難しい。
日本ではGPTを大学のレポートに使うことの是非が問われるが、そもそもGPTをはじめとした言語モデルの出力の良し悪しを判断することが、もはや人間にも機械にも難しくなってきているのだ。
Copyright © ITmedia, Inc. All Rights Reserved.


清水亮の「世界を変えるAI」
この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
AI学習への利用拒否をrobots.txtで一括指定へ OpenAIやGoogleなどが対応表明
-
2
総務省、GMO攻撃者サイトの「ブロッキング」を通信各社に要請 報道
-
3
「PayPay連携の銀行から、お金全部盗られた」被害報告……原因と対策は? PayPayに聞いた
-
4
楽天カード、本人認証をワンタイムパスワードに統一 27年2月から順次
-
5
「ITノウハウ持つ人材少なく」 PHP脆弱性問題、31市町村でサイト一時停止継続
-
6
「低評価でキャラが悲しげな目」 モスバーガーのアンケートがSNSで話題 運営会社に狙いを聞いた
-
7
松屋のアプリに不正アクセス、約238万件の個人情報が漏えい 停止中の補償も予定
-
8
日本郵政「ゆうID」不正ログイン、他社で流出したパスワード使うリスト攻撃か……2段階認証必須に
-
9
Binanceの約1兆円流出、北朝鮮ハッカー集団「TraderTraitor」の犯行か
-
10
グッスマ、顧客の2800人のカード番号全16桁+セキュリティコードなど流出か 下4桁は40万枚分
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR