


「RAGはそんなに簡単じゃない」──AIエンジニア主導でLLMを導入すると失敗に? 日本語特化のELYZA・曽根岡CEOに聞く、LLM開発&活用のいま(2/2 ページ)
独自ベンチマーク「ELYZA Tasks 100」を開発
モデルの性能評価では、2023年に独自のベンチマークテスト「ELYZA Tasks 100」を作成・公開している。これは、生成AIのテキスト出力を評価する指標で、100個の質問に答えた結果を人間が評価するものだ。
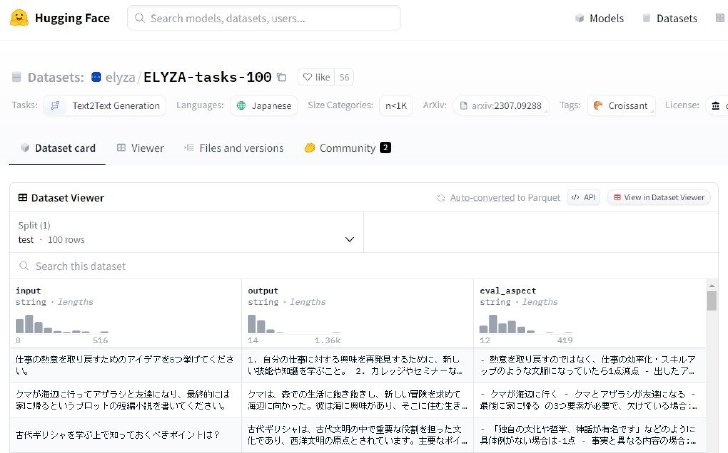 Hugging Face上で公開しているELYZAの独自ベンチマークテスト「ELYZA Tasks 100」 日本語のモデル評価に特化している
「当時は文章から単語を抜き出すようなベンチマークしかなく、チャットボットに期待する性能とは違った。そこで物語作成や歴史、算数など幅広い100のタスクからなるベンチマークを開発した。問題と出力結果、スコアもすべて公開し、公平性と透明性を重視している」
「RAGはそんなに簡単じゃない」
2024年の生成AI活用において、企業が持つ固有の知識をLLMに学習させる「RAG」(Retrieval-Augmented Generation、検索拡張生成)という手法に注目が集まっている。RAGは、関連する情報をLLMに検索・抽出させ、その情報を用いて回答を生成させる手法だ。これにより、LLMを企業特有のタスクに適用しやすくなると期待されている。
しかし、曽根岡CEOは「感覚的にはRAGはそんな簡単ではない。一時期のチャットボットのような幻滅期に入るのではないか」と指摘する。
「RAGは検索システムの精度と、LLMの精度を両方のチューニングを要する2変数問題だ。検索システムの精度の改善は難しい。Googleのような最高の検索システムでも、ベストマッチの記事が出るのが6、7割程度。社内ドキュメントの検索システムであれば、50%あればいい方だろう。そう仮定すると、LLMが検索したテキストは、まず50%の確率で間違っていることになる。LLMが写し間違いや解釈ミスをする可能性があるので、正答率を50%に到達させるのは難しいということになる」
RAGにおいて実用的な精度を高めるには、検索システムの改善や検索内容を最適化など、柔軟なアプローチを取るべきという。
「ゴールは正しいドキュメントを検索し、適切に回答することだ。社内ドキュメントから有休取得の期間を知りたいケースなら、『就業規則に関する質問ですか?』といったクッションを挟んで探索範囲を狭めるなど、いろいろ工夫の余地はある」
日本語の効率的な処理に向けたトークナイザーの改良
RAGの改良と共に曽根岡CEOは、トークナイザーにも注目しているという。トークナイザーは文章をLLMで扱う上で必要になる前処理ツールの一つで、文章をトークンという単位に分割する。人間にとっての単語とは必ずしも一致しないが、機械にとっての単語というのが近い概念だ。
「例えばGPT-3では英語の『Hello』は1トークンだが、日本語の『こんにちは』は3トークンになる。専門用語である『大規模言語モデル』だと11トークンにもなる。文章生成には膨大な処理が必要になる。これを1トークンとして扱えば、LLMの処理は11倍高速化することになる」
曽根岡CEOは、特定領域に特化したトークナイザーの構築による効率化の可能性を指摘する。
「医療文章を書くのに特化したトークナイザーだと、とても効率がよくなるかもしれない。あるいは、AIの研究の文章を書くのに特化したトークナイザーだと、すごい少ない処理で済むかもしれない。パラメーター数が5000億あるモデルよりも、少ない処理でできてしまうこともあり得る」
「モデルのパラメータ数は大きいほど良いのは間違い無いが、効率よく処理するアーキテクチャだったり、トークナイザーだったり、そのほか諸々の工夫は、LLM研究開発の競争においては非常に重要だ」
曽根岡CEOは、日本語LLMの開発競争において、モデルの大規模化と並行して、処理の効率化が重要な課題になると指摘している。特定分野に特化したトークナイザーの開発は、その有力な解決策の一つとして期待されている。
現場主導のLLM活用を
曽根岡CEOは「LLMの競争軸は汎用性から特化性に移行しつつある。日本語や法律、医療、製造業など特定分野に特化したモデルで差別化することが求められるようになる」と今後の技術トレンドを展望する。
「LLMの開発競争も汎用モデルで競おうという時代は、少しだけ変わってきている気がしている。この後はどう特色を出すかが重要になる。その特色の出し方も、どのようなタスクの性能が高いのかが重要になる」
「例えば日本語の法律をちゃんと知っているモデルや、日本の医療について詳しいモデル、日本の製造業や自動車製造業に特化したマルチモーダルのモデル。ユーザー企業がそのモデルを選ぶ理由が存在するということが、今後のLLM開発の競争の中で重要になる」
また、LLMのアプリケーション開発においては、現場の評価を重視すべきだと指摘した。
「現場評価ドリブンのLLM活用が広まってほしい。AIエンジニアが『これいい感じの出力だよね、決裁者の方もいいって言ってるから導入しよう』と進めると、現場の人からすると全然使えないAIサービスになってしまう。結局、現場で使える評価をできる人は現場にしかいない」と述べ、LLMの導入検討では、実際に使う人の評価軸でPDCAを回していくことが肝要だと強調した。
この点で強みとなるのがKDDIとの提携だ。曽根岡氏は「これからはKDDIという5万人いるグループ会社の皆さんと一緒に、現場の人と二人三脚でいろんなプロダクトを作る体制ができた」と、KDDIの営業力とネットワークを活用して、現場主導のLLMの事業化を加速させる考えを示した。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。
SpecialPR
アクセスランキング
-
1
JR九州の非IT部門がGeminiでPythonアプリを内製開発 2~3カ月で完成させた方法
-
2
【追記あり】M365障害、ChatGPT/Claudeのコネクタにも影響 「ほとんどのリクエストで動作しない」
-
3
再学習なしで正答率6倍 マサチューセッツ工科大学が実証した「AIがAIを直接直す」新手法
-
4
Google、高速で低価格の「Gemini 4 Hydrogen」発表 無料ユーザーも利用可能
-
5
「好機が来た」――なぜ今Sakana AIは、イチからAIモデルを作るのか “新たな一手”のねらいを聞いた
-
6
トランプ大統領、マスク氏やフアン氏ら6人に米国家科学賞と国家技術革新賞を授与
-
7
「AI処理、データ非保持が守られず」――Notionが委託先の問題指摘、漏えいの恐れ巡り
-
8
AIエージェントを「追えない、止められない」 約半数が経験する“暴走”、浮上する3つの盲点
-
9
AI「Muse」専用メアド開始、「日本で取れた」報告続々 メール送受信も任せられる
-
10
総務省が新しい無料オンライン講座「統計解析プログラミング」を1月に開講 Pythonでのデータ分析が4週間で学べる
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR