


Meta、初のリアルタイム音声認識モデル「Muse Voice Transcribe」 20人超の話者識別と多言語混在に対応
米Metaは9月1日(現地時間)、Meta Superintelligence Labs(MSL)が開発した初のリアルタイム音声認識モデル「Muse Voice Transcribe」を発表した。「Meta Model API」での価格は1時間当たり0.18ドルで、同日から提供している。
ストリーミングASR(音声認識)に加え、話者分離(ダイアライゼーション)と発話終了検知(エンドポインティング)を単一モデルで処理する。20人以上の話者を区別でき、1時間を超える音声にも後処理なしで対応する。学習に使った言語は70以上で、うち25言語を初期リリース時点で検証済みとしている。検証済み言語の例には日本語も挙げられている。1つの文の中で言語が切り替わる「コードスイッチング」もネイティブに扱い、言語、キーワード、文脈のバイアス指定で認識精度を高められるという。
技術面では、「Muse Spark」ファミリーの自己回帰型マルチモーダルモデルという位置付けだ。音声を80ミリ秒(12.5Hz)単位のチャンクで処理し、各チャンクで「次の音声を聞き続ける」か「テキストを出力する」かをモデル自身が判断する。単語ごとに難易度に応じて待機時間を変える「適応的ディレイ」を強化学習で獲得させ、精度と遅延のトレードオフを改善したとしている。
性能について同社は、Artificial Analysisのストリーミング音声認識ランキングと公開されている話者分離ベンチマークで1位としている。Artificial Analysisによると、確定文字起こしの単語誤り率(WER)は3.1%で、発話終了からの遅延は0.16秒にとどまり、Cartesia Ink-2(3.4%)やElevenLabsのScribe v2 Realtime(3.6%)を上回った。話者分離の平均誤り率は17.5%としている(いずれも9月1日時点の比較)。
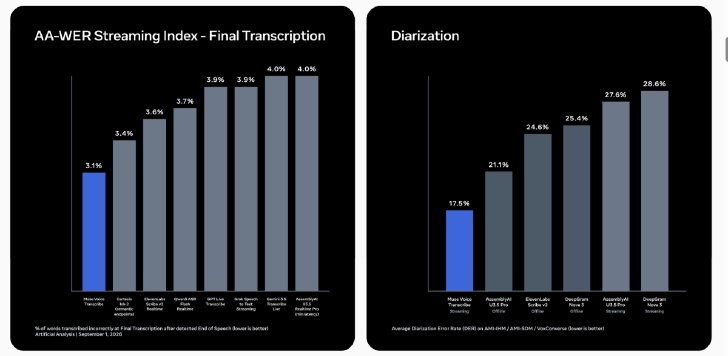 ストリーミング音声認識のWER(左)と平均誤り率(DER)(右)の比較。いずれも数値が低いほど高精度(画像:Meta)
APIとして開発者に提供する「Meta Model API」のほか、Mac版「Meta AI」とコーディング製品「Muse Code」で利用できる。
Meta AIとMuse Codeの音声入力機能は同モデルに切り替わっており、Macでは[Fn]キーを押している間、任意のアプリケーション上で音声入力を使えるとしている。
なお、公式ブログにモデルの重み公開についての言及はない。現時点での提供はMeta Model APIと自社アプリ経由に限られる。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
「菜の花がおかしい」――イラストレーター制作うたうマラソン大会ポスターに指摘相次ぐ 事務局がAI使用明かす【訂正あり】
-
2
くら寿司、10%割引の“適用漏れ”を謝罪 レシート持参で返金へ ちいかわコラボのお詫び施策
-
3
「ペンギンを返して」 Suica新キャラ候補3案公開でSNSに戸惑いの声 一般投票は8日から
-
4
幻の「ちいかわ」コラボ第3弾皿、捨てちゃうの? くら寿司に聞いてみた
-
5
藤井風のリサイタル、公式サイトがインターネット老人会すぎると話題 公民館のチラシみたいだけど東京ドーム開催
-
6
「ペンギンを返して」→「3匹全部採用して」 批判殺到のSuica新キャラ、ファンアートが空気を変えた? SNSの声
-
7
Duolingoの新アイコンが「気持ち悪い」 世界のユーザーから「元に戻して」の声
-
8
農水省の“クソダサ”ポスター話題 「AIよりよっぽど良い」の声も 担当者に狙いを聞いた
-
9
大雨で「首都圏外郭放水路」稼働 濁流が“地下神殿”を満たすまでの動画公開 国交省
-
10
5年ぶりの「PEN」、OM SYSTEMロゴになって登場 EVFを搭載、初の防塵・防滴仕様に
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR