




















3月末のGoogle Cloud障害の原因判明 分散アクセスコントロールへの大量の変更要求が引き起こしたメモリ不足
この記事は新野淳一氏のブログ「Publickey」に掲載された「Google Cloudの主要サービスが10時間ものあいだ障害発生。原因は分散アクセスコントロールへの大量の変更要求が引き起こしたメモリ不足」(2020年4月10日掲載)を、ITmedia NEWS編集部で一部編集し、転載したものです。
米Googleが提供するパブリッククラウドサービス「Google Cloud Platform」は、米国太平洋時間の3月26日木曜日 午後4時50分(日本時間27日金曜日 午前8時50分)頃から10時間ほど、Google Compute EngineやCloud Storage、Cloud SQLをはじめとする主要なサービスで障害を起こしていました。
受けた影響はリージョンごとに異なりますが、ほぼ全てのリージョンに何らかの影響があったようです。
Googleはこのほど、その原因についての調査結果を発表。原因は「Google Cloud内部でアクセスコントロールをつかさどる部分に障害が発生したことだった」と説明しました。
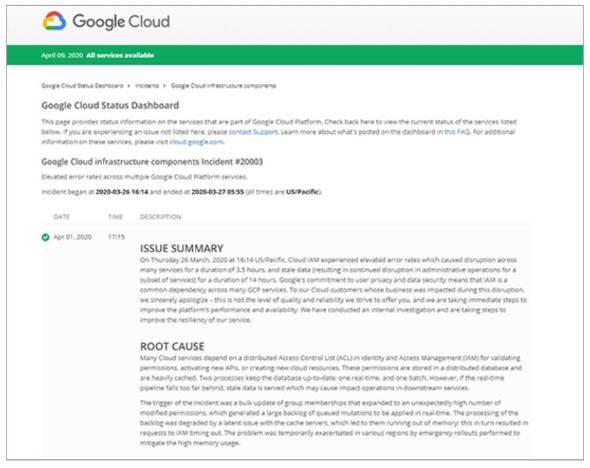
アイデンティティーマネジメントへの大量の更新要求がキャッシュサーバの障害に
クラウド内部では、APIへのアクセス時やリソースの確保などあらゆる場面で適切な権限によって実行されているかを確認するための認証が行われています。この認証はアイデンティティーマネジメント(IAM:Idenntity and Access Management)の一環として分散アクセスコントロールサービスによって実行されています。
そして分散アクセスコントロールサービスは分散データベースによって構築されています。
Google Cloud内部では、この分散データベースに対する最新の状態を反映するアップデート処理として、つねにリアルタイム処理とバッチ処理の2つのプロセスが走っています。
しかし何らかの原因でリアルタイムのアップデート処理のどこかであまりにも大きな遅延が発生すると、古いデータによって更新が行われてしまい、これが関連するサービスに悪影響を及ぼすことがあります。
これがGoogle Cloudの主要なサービスを障害に巻き込んだ原因でした。以下はGoogleが公開した報告書の「ROOT CAUSE」(根本原因)の部分から引用します。
The trigger of the incident was a bulk update of group memberships that expanded to an unexpectedly high number of modified permissions, which generated a large backlog of queued mutations to be applied in real-time. The processing of the backlog was degraded by a latent issue with the cache servers, which led to them running out of memory; this in turn resulted in requests to IAM timing out. The problem was temporarily exacerbated in various regions by emergency rollouts performed to mitigate the high memory usage.
インシデントの引き金となったのは、グループメンバーシップの一括更新でした。これによって予想以上にパーミッションの変更が多くなり、リアルタイムに適用すべきキュー遷移に大量のバックログが発生しました。
この大量のバックログ処理はキャッシュサーバの潜在的なバグを引き起こし、(キャッシュサーバの)メモリを使い尽くしたのです。これがIAMに対するリクエストのタイムアウトを発生させる結果となりました。しかもこれは、メモリ使用量の増加を緩和するために実施された各地の緊急のロールアウトにより、一時的に悪化しました。
IAMへの大量の変更要求によるバックログがキャッシュサーバのバグを呼び、メモリ不足を誘発。それがタイムアウトにつながったということです。
そしてアクセスコントロールが止まってしまえば、APIへのアクセスもリソースの確保も新たに実行できなくなります。これが主要なサービス全体に障害が影響した理由です。
Googleはその後この原因を発見し、更新されたキャッシュを反映するためのオフラインジョブを手動で開始しました。さらに、追加のメモリを使用してキャッシュサーバを再起動させるなどして障害対応を進めていき、約10時間後に障害からの復旧を果たすのです。
そして今後こうした障害が発生しないように、キャッシュサーバがバルクアップデートに対応できるようにし、メモリの使用効率も改善。また、緊急時の対応用にキャッシュサーバのコンフィグレーションをリスタートなしに変更できるようにもすると説明しています。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
資さんうどん、従業員の退職理由などが外部から閲覧可能に 委託先の勤怠システムに設定不備
-
2
NEC、委託先の情報漏えいで謝罪 「セキュリティ事業を手掛ける企業として反省」
-
3
Google、「Gemini 4 Carbon」発表 「Argon」公開から2週間、サイバー防御能力などを強化
-
4
渦中のGMO、熊谷代表の発信は“火に油”か? 「経営トップが自ら広報」の功罪
-
5
JALの予約システムに不正アクセス 約9万人分の予約情報が漏えい 一部ではパスポート番号も
-
6
Apple、初のタッチ対応「MacBook Pro」発表 新型OLED搭載、国内価格は49万9800円から
-
7
VTuber「兎田ぺこら」グッズにSNSで風評被害→示談成立 「保護者同伴で謝罪などがあったため」
-
8
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
9
「ツイキャス」不正アクセスで停止 復旧までに「相応の時間」
-
10
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR