




















AWS、Alexaのクラウド処理をGPUから独自チップに切り替え 高速化でサーバコストを大幅削減
米Amazon Web Services(AWS)はこのほど、音声アシスタント「Amazon Alexa」のクラウドサーバ側の処理の多くを、GPU処理から独自チップによる処理に切り替えたと発表した。
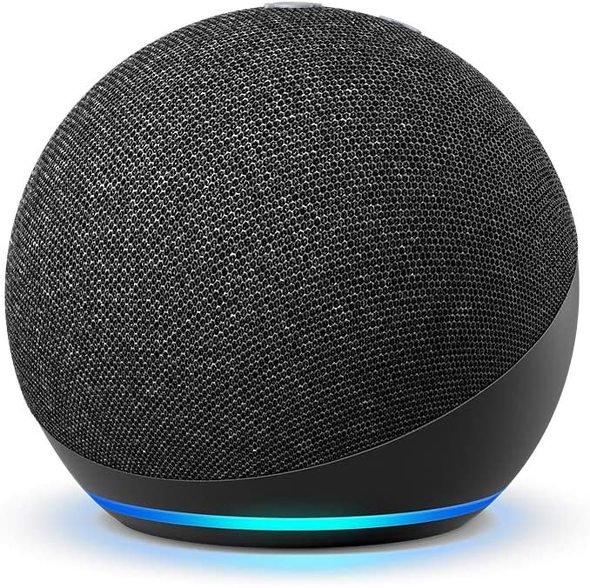 Amazonの最新スマートスピーカー「Echo Dot」
AmazonはAlexaからの応答のTTS(Text-to-Speech)処理をサーバに搭載したGPUを利用する形で開発し、そのままGPUを利用してきた。しかし開発チームは利用者に不自然さを感じさせないために、そしてサーバの計算コストを抑えるために独自開発の専用チップによる処理に切り替えることを決めた。
AWSによると、Alexaのサーバ側の処理をGPUから独自開発の「AWS Inferentia」に切り替えたところ、処理の遅延(レイテンシ)が25%短くなり、サーバのコストを30%削減できたとしている。開発チームは、遅延を短縮できたことで、今後より複雑なアルゴリズムを導入し、品質の高いサービスをユーザーに提供できると考えているそうだ。
AWS Inferentiaを組み合わせたAmazon EC2(Elastic Compute Cloud)の「Inf1」インスタンスと併せて、2019年12月に開催したイベント「AWS re:Invent 2019」で発表している。
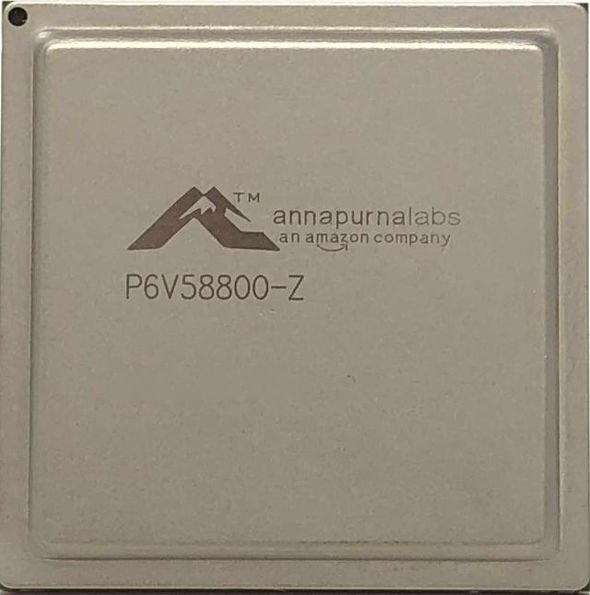 独自開発の専用ASIC「AWS Inferentia」
AWS Inferentiaは、人工知能の処理の中でも推論(Inference)をごく短い遅延で処理するASICだ。FP16(半精度浮動小数点数)とBF16(Bfloat16、Brain Floating Pointとも呼ぶ)の2種類の16ビット浮動小数点数データを64teraOPSで処理する。これはFP16とBF16を混在させた状態で処理しても同じだそうだ。さらに、8ビット整数のデータは128teraOPSで処理する。
AWS Inferentia ASICを組み合わせたEC2インスタンス「inf1.xlarge」の利用料金は1時間当たり0.368ドル(1年間、3年間の予約をすれば利用料金は下がる)。一方、NVIDIAのデータセンター・サーバ向けGPU「NVIDIA T4」を組み合わせたEC2インスタンス「g4dn.xlarge」の利用料金は1時間当たり0.526ドル(1年間、3年間の予約をすれば利用料金は下がる)。
AWS re:Invent 2019でInf1インスタンスが登場するまでは、NVIDIA T4 GPUを組み合わせたG4インスタンスが、推論向けインスタンスとしては最も利用価格が安かった。そしてAWSは、AWS Inferenceを組み合わせたInf1インスタンスは、NVIDIA T4 GPUを組み合わせたG4インスタンスに比べて処理のスループットが30%高いと主張している。低コストでAIの推論アルゴリズムを利用したいユーザーにとっては、AWS Inferentia ASICとG4インスタンスは有力な選択肢になるだろう。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
GMO、ランサム被害にあった顧客に新しいPC提供へ 犯行グループは1人の顧客情報公開か
-
2
NECのルータ「Aterm」、PHP脆弱性の影響なし 設定画面URLの「.php」は無関係
-
3
GMO、不正アクセス実行犯の手がかりに懸賞金 1億5000万円規模
-
4
「楽天トラベル」に不正アクセス 顧客情報最大約260万件など流出か 予約者約3.6万件のクレカ情報も
-
5
GMO、攻撃者の公開情報に「アクセスは絶対に控えて」 悪質な拡散者には法的措置を準備
-
6
Google、プライバシーポリシーに「Gmail」「Googleフォト」のデータを広告に使う例外を追加 回避方法は
-
7
So-net、会員情報約259万件が漏えい 一部メールサービスではパスワードも流出
-
8
メアドを検索→AIで“その人専用フィッシングメール”を生成する手法、クリック率が約2.7倍に 7000人以上で実験
-
9
IPO目論見書に「AIは人類の存亡リスク」「コードの9割はClaude製」 Anthropicが示した規格外の見立て
-
10
GMO不正アクセス、犯人側は「27日に顧客のPC攻撃」予告 GMOが端末回収、ホワイトハッカーが解析中
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR