




















Meta、音声生成AIモデル「Voicebox」発表 ノイズ除去や言い間違い修正、多言語会話など多機能
米Metaは6月16日(現地時間)、新たな音声生成AIモデル「Voicebox」を開発したと発表した。音声の編集、サンプリング、スタイルの設定などを行える。
音声とテキストを入力することで、以下のような音声を出力できる。
- 入力した声で入力したテキストを読み上げる音声クリップを作成する
- 録音した音声から犬の鳴き声やブザー音などのノイズを除去する
- 録音した音声の言い間違いを修正する
- 1つの言語のスピーチを同じ声のまま別の言語に変換する(英語の音声を仏語に、など)
- 1つのテキストを多様な声で読み上げる
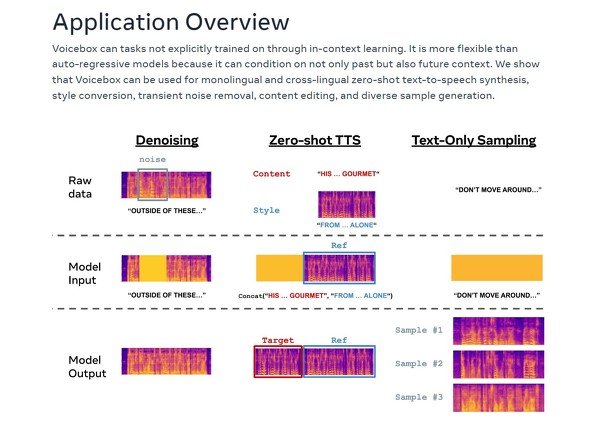 アプリケーションの概要
Metaは、Voiceboxで将来的にはメタバース内のバーチャルアシスタントやNPC(ノンプレイヤーキャラクター)が自然な声で話せるようになるとしている。また、自分の声のまま(本来は話せない)外国語で会話したり、映画の吹き替えも声優ではなく本人の声で行えるようになるという。
Voiceboxは、「非自己回帰フローマッチングモデル」に基づく音声生成モデル。大規模データを使ってテキストによる音声入力タスクの解決方法を学習することで、コンテキスト内学習を通じて音声タスク全体で単一目的のAIモデルよりも優れたパフォーマンスを発揮するとMetaは説明する。
トレーニングには、英語、フランス語、スペイン語、ドイツ語、ポーランド語、ポルトガル語によるパブリックドメインのオーディオブックの音声とそのトランスクリプト、5万時間分を使った。
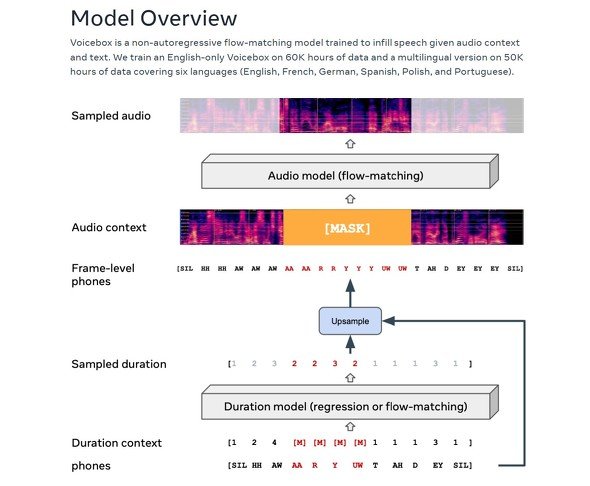 非自己回帰フローマッチングモデル
Metaは、非自己回帰フローマッチングモデルは、「最先端の自己回帰モデルのTTSより最大20倍の速度で音声を生成する」としている。例として、米Microsoftの「VALL-E」を挙げた。
Metaは論文やサンプル集は公開したが、アプリやソースコードは公開していない。「他の強力な新しいAIイノベーションと同様、このテクノロジーが誤用や意図しない危害をもたらす可能性があることを認識している」からだ。「AIの最先端を前進させるために研究を共有することが重要であると信じているが、オープンさと責任の間の適切なバランスをとることも必要」としている。
TTSの悪用は既に問題になっている。最近ではドレイクとザ・ウィークエンドの声を無断で使った生成型AI楽曲がSpotifyで公開され、話題になった。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
たばこ休憩なき時代の“一服”をどう取るか 温熱と“聞こえない音”で休む、JT子会社のアイマスクを試す
-
2
パナソニックHD子会社、使用禁止の生成AIに従業員約33万人分の個人情報をアップロード
-
3
「Claude Mythos 5」、危害の兆候を顧みず実在の開発者を標的に──AnthropicとAISIが分析結果を公開
-
4
GMO、不正取引の被害額を補償へ 見舞金5000円も 「お名前.com」FX用VPSへのサイバー攻撃で
-
5
PHP脆弱性でいち早くサービス停止したコドモン 背景に「被害が出てからでは取り消せない」
-
6
B級感がたまらない? 映画「ストリートファイター」の魅力と原作ゲームの歴史、ゲーマーマンガ家が熱弁
-
7
「能動的サイバー防御」きょう開始 警察・自衛隊などが攻撃元サーバを無害化 高市首相も狙いを説明
-
8
GMO、「能動的サイバー防御」発動を政府に要請 「お名前.com」FX用VPSへの攻撃で
-
9
「お前らの作品は所詮コピーだ」――富野由悠季さん、プロ論を語る
-
10
「AIでエンジニア派遣は不要になる」のか? 各社に肌感を聞いた 求められる人材、明確に変化
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR