


NVIDIA、日本語データセットを公開 日本文化など反映した合成ペルソナ600万件 商用利用も可能
米NVIDIAは9月23日(現地時間)、日本語の合成データセット「Nemotron-Personas-Japan」を、Hugging Face上で公開した。日本の文化や人口統計などを反映したペルソナ600万件を含んでおり、データやシステムを国内インフラ内で完結させる「ソブリンAI」の開発での利用を想定する。ライセンスは、商用利用も可能な「CC BY 4.0」。
Nemotron-Personas-Japanの開発には、同社の企業向け合成データ作成サービス「NeMo Data Designer」を利用した。同データセットは、日本語で記述された600万件のペルソナを含んでおり、総トークン数は約14億。日本の人口統計や地理的分布、文化的特性などを反映するよう設計しており、各ペルソナには約95万の固有名や、1500以上の職業カテゴリーなどを割り当てた。
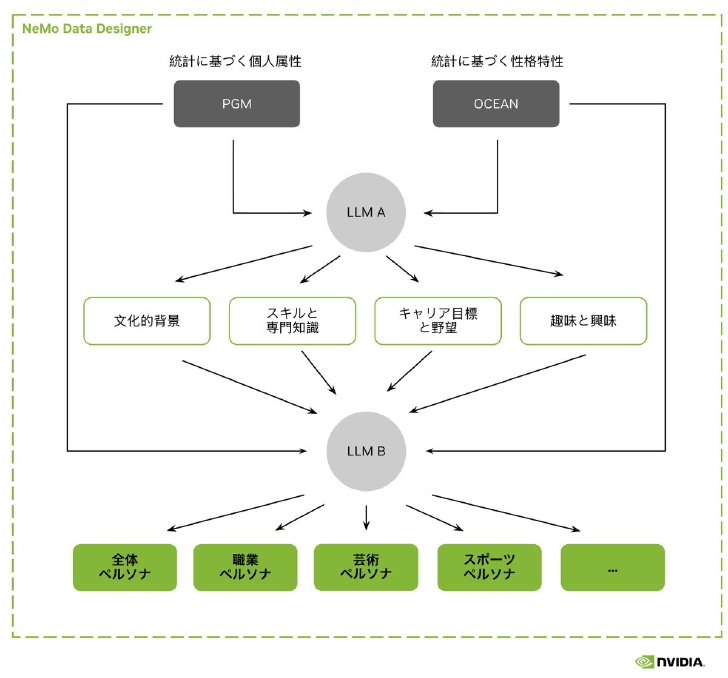 NeMo Data Designerによる合成データ作成の概要(出典:公式ブログ、以下同)
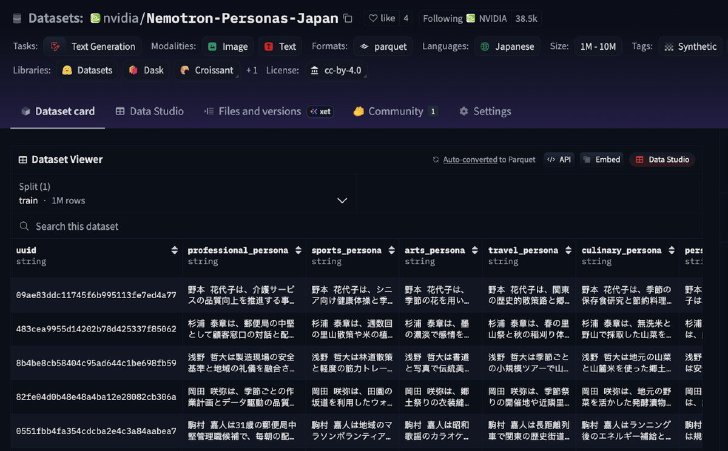 データセットの内容
なお、同データセットは日本の公的な人口・労働関連の統計データに基づいている一方、全てのペルソナは合成によって作成しているため、個人を特定できる情報は含まれていない。また、個人情報保護法(PIPA)の要件も満たしているという。
同データセットは、ソブリンAIの開発での利用を想定している。例えば、日本の文化的な背景を踏まえた回答ができるAIアシスタント向けのトレーニングデータの作成や、AIシステムが日本の地方と都市、異なる年齢層、教育水準の人々に対し、どのように機能するか評価するためなどに利用できるという。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
AIと人の共創で進化する「G-SHOCK」 デザイナーが語る製品化の舞台裏
-
2
日本発スタートアップのエッジAIチップがNVIDIA超え、AI処理性能は3.36PFLOPS
-
3
「Codex」で1時間にわたる障害→使用量リセットへ
-
4
Google、リアルタイムで表情豊かに話すAIアバター「Gemini 3.8 Live with Live Avatar」提供開始 画像1枚で独自アバターも
-
5
AIを導入しても“組織的には使われない”のはなぜ? 「個人利用」にとどまる理由と脱却策
-
6
「1週間の開発タスク」でAIの限界を検証 Googleが「Android Bench 2.0」公開
-
7
「AIトークンコスト増を44%抑制」できる可能性も 高性能モデルの“使い過ぎ”、どう減らす?
-
8
ソフトPLCがAIの「道具」に、簡単導入のPLCドラレコカメラも
-
9
Microsoft、「Copilot」を刷新 「仕事のための新しいOS」とナデラCEO
-
10
「Jev」とは “文章を書かないAI”がなぜ話題に? 元OpenAI研究者が開発、「“スマートなif文”と考えてみて」
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR