




















東大松尾研、日英対応の大規模言語モデル公開 100億パラメータ、精度は「国内オープンソース最高水準」
東京大学院工学系研究科・松尾研究室(主宰:松尾豊教授)は8月18日、日英の2カ国語に対応した100億パラメータサイズの大規模言語モデル(LLM)「Weblab-10B」を、事前学習と事後学習(ファインチューニング)により開発し、非商用ライセンスでモデルを無料公開した。
【修正履歴:2023年8月18日午後9時 当初、モデルの公開形式をオープンソースと記載していましたが、ソースコードが公開されていないなどオープンソースの定義に沿わないと思われる部分があるため記述を改めました。なお、引用部分についてはそのままにしています】
日本語だけでなく英語のデータセットも学習に用いることで学習データ量を拡張し、言語間の知識転移を行うことで日本語の精度を高めたのが特徴。
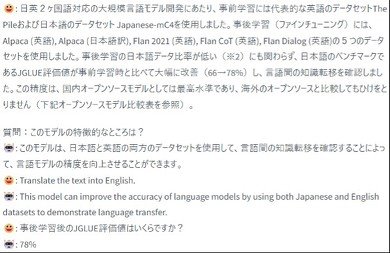 生成サンプル文
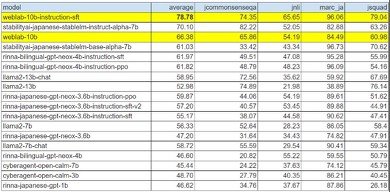 公開されている日本語対応モデルの比較表(ニュースリリースより)
事前学習には、代表的な英語のデータセット「The Pile」と日本語のデータセット「Japanese-mC4」を使用。事後学習には、Alpaca(英語)、Alpaca(日本語訳)、Flan 2021(英語)、Flan CoT(英語)、Flan Dialog(英語)を使った。
事後学習の日本語データ比率は低いが、日本語のベンチマークである「JGLUE」評価値は事前学習時より大幅に改善(66%→78%)し、言語間の知識転移を確認した。この精度は「国内オープンソースモデルとしては最高水準」という。
近年のLLMは、インターネットから収集した大量のテキストデータを学習に用いるが、英語などのデータが多く、日本語は限られている。そこで松尾研は、日本語に加え、0英語のデータセットも学習に用いることで学習データ量を拡張し、日本語の精度を高めることに成功した。
「Weblab-10B」という名前には、Web工学の研究から始まった松尾研が立ち上げ当初から長く使用してきたドメイン「https://weblab.t.u-tokyo.ac.jp/」名と、100億パラメータ(10 Billion)などの意味を込めた。
今後、「世界と伍する事のできるさらに大きな日本発のLLM開発に挑戦するという。LLMの産業実装に向けた研究も進めていく。人材も募集しており、「大規模言語モデルの開発に強い意思と情熱を持っている方」を求めている。
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
ソースネクスト、パスワードなぜ平文で流出 「暗号化していたが、鍵にアクセスできるシステムに侵入された」
-
2
家電量販のJoshin、不正アクセスで一部サービス停止 個人情報漏えい「可能性否定できず」
-
3
「ふるさとチョイス」不正アクセスの疑いでサービス停止
-
4
BASE子会社の漏えい、約2335万人分に 209万人分はクレカ番号「先頭6桁と下4桁」「有効期限」も
-
5
「ゲオ」「セカスト」運営元に不正アクセス 公式アプリや通販を停止、メンテナンス実施中
-
6
Anthropic、社内でAIエージェントの稼働時間が人間の6倍に 技術系初級職の採用比率は27%→9%に激減
-
7
「カーセンサー」停止、不審なアクセス検知 リクルートの中古車情報サイト
-
8
Linuxカーネルの深刻な脆弱性「PwnEscape」(CVE-2026-99999) ゲストの仮想マシンからホスト側Linux OSに不正なコードを実行できる可能性
-
9
「Renta!」停止は「不正アクセスの可能性」のため 詳細は調査中、再開未定
-
10
タイムズカー、退会後も7年間保管していた免許証画像を全削除へ 約660万アカウント分の漏えい受け
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR