




















PDFから構造化テキスト抽出、EPUBを半自動生成 その仕組みは
ソフトウェア開発などを手掛けるイースト(東京都渋谷区)は7月、見出しや本文などのテキスト情報を含むPDFファイルを、Markdown形式のテキストに変換できる技術を発表した。同社はこの技術を活用し、PDFを電子書籍向けのフォーマット「EPUB」ファイルに半自動で変換するサービス「EPUBpack」を出版社などに提供。第1弾として岩波新書の電子書籍化を進めている。同社は8月7日にEPUBpackの説明会を開催。サービスの仕組みと開発の経緯を紹介した。
PDFから電子書籍を作る「EPUBpack」
EPUBpackは、PDFからテキストや画像などの素材を取り出し、Markdown形式のテキストに変換。元のレイアウトのまま、EPUBに組み直す。
テキストの抽出や、MarkdownからEPUBを作る工程には、同社がこれまでに提供してきた製品やサービスの機能を強化したシステムを採用。ルビや傍線などの表現も正しく抽出でき、新聞社や出版社による社団法人「日本電子書籍出版社協会」が定めた電子書籍の共通仕様に忠実なEPUBを作れるという。
PDFからEPUBを作る流れ
PDFからEPUBを作る工程は「PDFからテキストや画像を抽出する」「Markdown形式のテキストをEPUBに変換する」に大きく分けられる。初めてEPUBを制作する場合は、電子書籍の共通仕様や出版社固有のルールを基に、細かい表記ルールを定める作業もある。
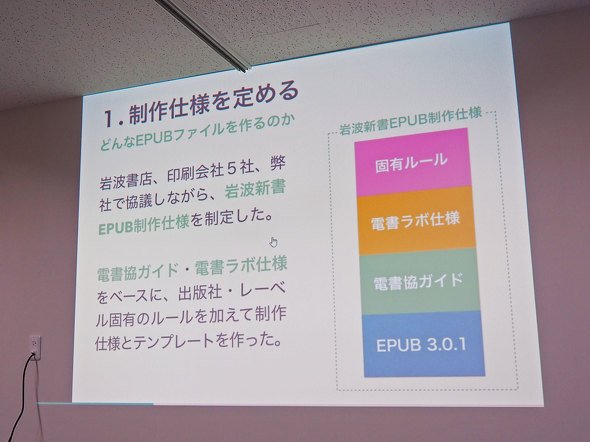
岩波書店の場合は、最初に印刷会社5社と協議しながら広告ページや俗字の扱い、奥付などの表記ルールを細かく定めた。EPUBに変換するときに表紙や本文などのテンプレートをあらかじめ決めておくことで、調整作業を最低限に抑えられる。
EPUBの仕様が固まったら、PDFからテキストを抽出するシステム「pdf2md」を使って、テキストや画像を取り出す。pdf2mdはOCR機能で画像から文字を抽出するシステムではなく、テキスト情報があるPDFからテキストを抽出して、正しい形に整形するシステムだ。
一般的なPDFリーダーでテキストをコピーしようとすると、段落に関係なく1行ごとに改行が挟まれたり、ヘッダやフッターなど本文とは関係ないところもコピーされたりするが、pdf2mdでは正しく読み取れる。
変換が「半自動」である理由
とはいえテキストを正確に読み取るには事前準備が必要で、全自動というわけではない。テキストを抽出する前に、手作業で文中の見出しや図形などにマークを付ける必要がある。PDFのテキストには本文や小見出しなどを判別する情報が含まれていないためだ。
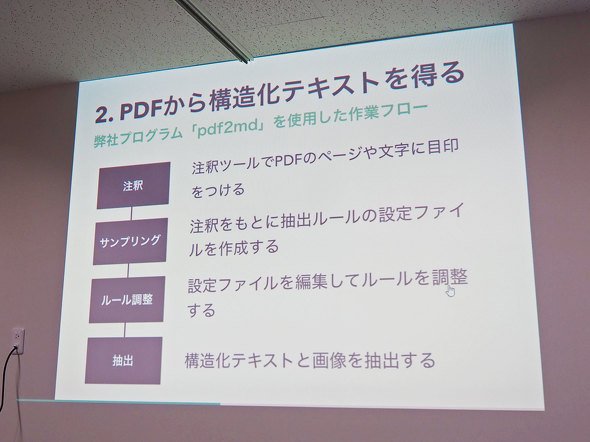
マークした情報を基に、テキストを抽出するルールを定めた設定ファイルを作り、PDFとともにpdf2mdに読み込ませると、画像やMarkdown形式のテキストを抽出できる。
見出しの他にも、図形や横書きページ、奥付や著者プロフィールなどもマークしていく。見出しの場合は、最初の一つだけマークすれば、フォントを基準に別の見出しも自動で判別させられるようになる。ゆくゆくはマークを付ける作業も自動化したいという。
テキスト抽出後は、手作業で修正や編集を加える。縦書きの場合の数字や記号の向き、特殊文字を修正したり、出版社の要望で電子書籍用に内容を書き換えたりする。
編集作業の後、Markdown形式のテキストと画像などをシステムに読み込ませることでEPUBに変換できる。デモンストレーションでは200ページ程度の新書を数十秒で変換していた。
過去の経験と資源を生かしたシステム開発
イーストは2004年から開発者やSIer向けにPDF関連ソフトウェアの販売やサポートを行ってきた。10年には総務省の「電子書籍基盤整備事業」に参加し、世界標準として定められたEPUBを日本向けに拡張した仕様を定めている。
同社が、PDFからフォント情報や文字、図形の位置情報などを取り出すライブラリ「PDF Textractor」を発売してから、医学分野で「論文のPDFからテキストを抽出したい」という反応があったという。「世の中にあふれているPDFから、テキストを正しく取り出す技術には十分な需要がある」と考え、電子書籍化までをパッケージ化したEPUBpackのサービスを開発した。
その後、岩波書店から「PDFの書籍データからテキストを抽出したい」という話が持ちかけられ、岩波新書のPDFからEPUBを作ることになった。
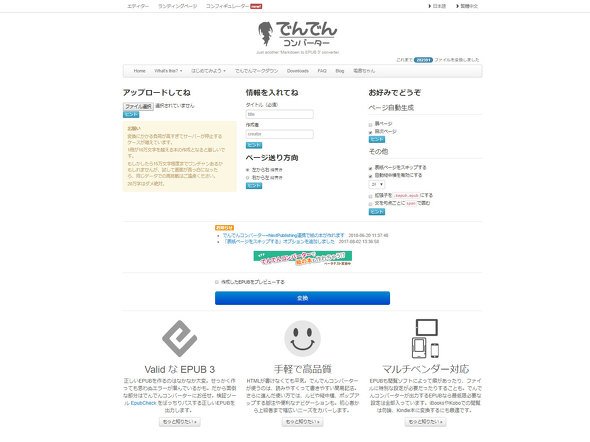
PDFをEPUBに変換する技術は、イーストがすでに製品やサービスとして提供してきたものがベースになっている。PDFからMarkdown形式のテキストを作る工程にはPDF Textractorの技術が使われ、テキストをEPUBに変換する工程では、同社がこれまでWeb上で一般公開していた無料のテキスト→EPUB変換サービス「でんでんコンバーター」のエンジンをビジネス向けに強化したものが使われている。
EPUBpackには課題もある。現状は1ページに2列以上のカラムがある書籍が苦手で、雑誌や複雑なレイアウトの学術書に対応できないという。電子書籍の印刷事業として出版社にPDF形式の書籍サンプルをもらって実験しながら機能を拡張していくとともに、マークを付ける作業や修正作業の自動化も見据えて開発を進めたいとしている。
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia NEWSに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
本日の新着記事
アクセスランキング
-
1
パナソニックHD子会社、使用禁止の生成AIに従業員約33万人分の個人情報をアップロード
-
2
PHP脆弱性でいち早くサービス停止したコドモン 背景に「被害が出てからでは取り消せない」
-
3
AIに200万円渡してネットショップを1年運営させてみた──Alibabaの研究者らがシミュレーション 資産14倍の例も
-
4
「Claude Mythos 5」、危害の兆候を顧みず実在の開発者を標的に──AnthropicとAISIが分析結果を公開
-
5
人に注射を打てる「サイボーグゴキブリ」の群れが、がれき下の被災者を救助? 実験成功率72%
-
6
「お名前.com」 のFX自動売買VPS、不正アクセスで金銭被害か 「600万円の損失」「55万円なくなった」……報告相次ぐ
-
7
タイムズカー、3000円の見舞金支払いへ 免許証画像漏えいの146万件対象 55億円の特損計上
-
8
1000万のWebサイトで「生きたAPIキー」が大量に“丸見え”状態? 大手銀行やインフラの鍵も 米スタンフォード大などが調査
-
9
トランプ大統領、Googleに「大西洋」の改名を打診 ピチャイCEOが「大洋は勘弁を」と難色
-
10
「AIでエンジニア派遣は不要になる」のか? 各社に肌感を聞いた 求められる人材、明確に変化
ITmedia NEWS SNS
 @itmedia_newsをフォロー
インフォメーション
注目情報をチェック
ITmediaNEWSをフォロー
あなたにおすすめの記事PR