


Sakana AI、複数の画像を扱える“日本語視覚言語モデル”公開 非英語圏での先駆けに
AIスタートアップのSakana AI(東京都港区)は8月2日、複数の画像について日本語で質疑応答できるAIモデル「Llama-3-EvoVLM-JP-v2」を発表した。このモデルは、同社が提案する生成AIの開発手法「進化的モデルマージ」で開発した視覚言語モデル(VLM)。作成したAIモデルなどはHugging Faceで公開中。
 Sakana AI、複数の画像を扱える“日本語視覚言語モデル”公開
「Llama-3-EvoVLM-JP-v2」の特徴は、複数の画像を扱えること、日本語で応答できることだ。例えばこのAIモデルに、2枚の犬の画像を見せて「それぞれを簡単に説明してください」と質問すると、犬種や身に着けている装飾品など、質問に対する回答を日本語で返してくれる。米Metaが公開しているAIモデル「Llama-3」をベースにしており、同社が過去に公開したAIモデルよりも性能が向上しているという。
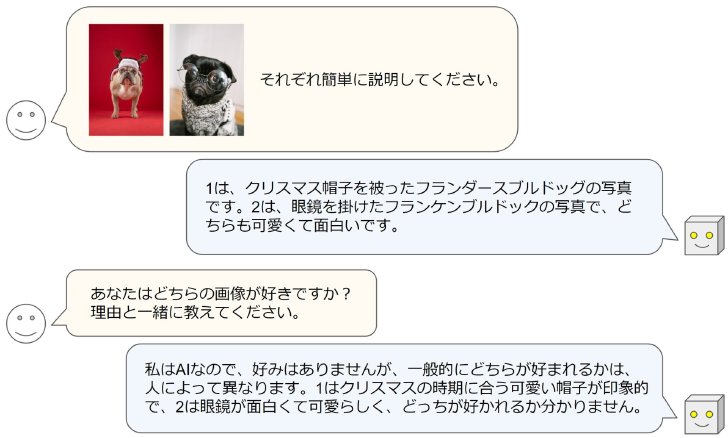 複数の画像について日本語で適切に応答してくれる例
これまでも、画像に対する説明や質疑応答のできるVLMが多く公開されてきた。しかし、そのほとんどが英語圏で開発されたもので、非英語圏で複数の画像を扱えるAIモデルは少ないという。そこで同社は、進化的モデルマージというAI開発手法で、日本語VLMの構築に挑んだ。
この手法は、複数の基盤モデル(大規模なデータセットによる事前学習で各種タスクに対応できるモデル)を組み合わせ、それぞれの特徴を併せ持つ新たなモデルを作るというもの。今回のケースでは「複数の画像を扱える英語のVLM」と「日本語の能力に長けた大規模言語モデル」「1枚の画像の説明能力に長けたVLM」の3つのモデルを使って「高性能な複数の画像を扱える日本語のVLM」を生み出すことに成功したという。
Sakana AIは開発したVLMの性能を評価するため、新たな評価用データセット「JA-Multi-Image-VQA」を作成。結果、モデルマージのベースに使ったVLM(Mantis-8B-SigLIP)よりも高いスコアを記録し、性能が上がっていることを示した。このデータセットや、Web上で試せるデモページなどもHugging Face上で公開している。
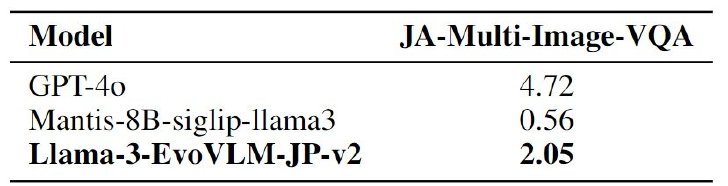 ベースに使ったVLMの約4倍のスコアを記録している「Llama-3-EvoVLM-JP-v2」
Copyright © ITmedia, Inc. All Rights Reserved.


関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
「Copilot案件」が急増、1年半で13倍に フリーランスに求められるニーズの変化
-
2
Google AIサブスクに「Colab」有料特典をバンドル 「高性能GPU」にアクセス可能に
-
3
「Gemini 4」は年末までに発表――開発責任者が言及か 「Googleは確かに最先端」と主張
-
4
NECが「AI自律型組織」を新設 「従業員はいらなくなる?」の問いに、CAXOはどう答えたか
-
5
高額GPUを買っても成果ゼロ? 「プライベートAI」の落とし穴
-
6
Claudeがブラウザを自律操作する「Claude in Chrome」一般提供 プロンプトインジェクションをどう防ぐ?
-
7
ゼロから声を作れる音声生成モデル「Gemini 3.8 Flash TTS」公開 「Gemini Notebook」でも利用可能に
-
8
「VMware離れ」は本当か 3000社がVCF 9にかじを切った現実的な理由
-
9
資生堂、AIエージェントで原料探索時間を95%削減 研究員の「目利き」を複数LLMで再現
-
10
AI全部入り「Microsoft 365 E7」に企業が二の足を踏む訳 移行意向はわずか4%
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR