


“学習データも全てオープン”なLLM、NIIが公開 GPT-3級モデルのプレビュー版
国立情報学研究所(NII)は9月17日、パラメータ数約1720億の大規模言語モデル(LLM)のプレビュー版「LLM-jp-3 172B beta1」を公開した。NIIが開発するLLMは、データをフルスクラッチで学習しており、AIモデルの他に学習データもオープンになっているのが特徴。プレビュー版モデルは、学習データの約3分の1までを学習した段階のものになる。
 “学習データも全てオープン”なLLM、NIIが公開
今回公開したLLMのパラメータ数は約1720億で、米OpenAIのLLM「GPT-3」と同程度の規模。ベースモデルは米MetaのLLM「LlaMA-2」を使った。
学習用データには、約2.1兆トークン(おおよそ単語数の意)のデータを用意。そのうち日本語は約5920億トークンで「WebアーカイブCommon Crawl(CC)全量から抽出・フィルタリングした日本語テキスト」「国立国会図書館インターネット資料収集保存事業(WARP)で収集されたWebサイトのURLを基にクロールしたデータ」「日本語Wikipedia」「KAKEN(科学研究費助成事業データベース)における各研究課題の概要テキスト」を利用した。
この他に、英語を約9500億トークンや、中国語や韓国語などの他言語を約10億トークン(中国語・韓国語)、プログラムコードを約1140億トークンを学習。ここまでの約1.7兆トークンのデータに加えて、日本語学習データのうち約4000億トークンは2回学習しており、学習データの合計は約2.1兆トークンとなる。
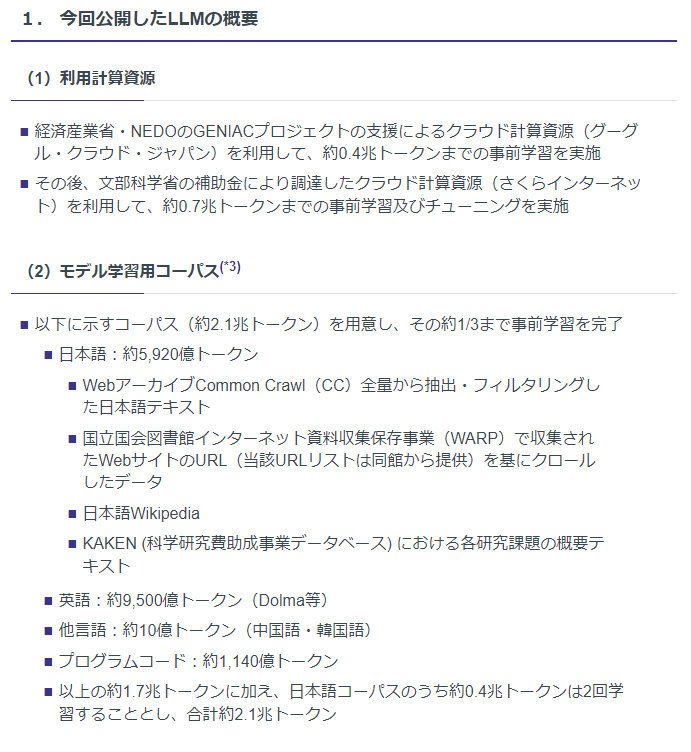 公開したLLMの概要
なお、プレビュー版モデルは約2.1兆トークンのうち、約3分の1までの事前学習を終えたものとなる。12月ごろには、2.1兆トークン全てを学習したAIモデルも公開する予定。
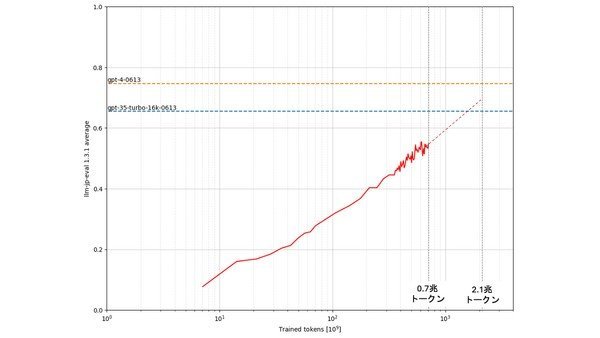 公開したLLMの評価について 7000億トークン学習時点の事前学習モデルは0.548を達成(評価には「llm-jp-eval v1.3.1」を使用)
Copyright © ITmedia, Inc. All Rights Reserved.


この記事の著者

関連記事
こんなメディアも見られています
ITmedia AI+に関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。
SpecialPR
アクセスランキング
-
1
ローカルLLM利用のクリニックを受診してみた PCマニアの院長が自力で構築、その導入効果は?
-
2
画像生成AIは既存のキャラクターをどれくらい出力する? ソニーAIなどが14モデルを調査
-
3
クラウドインフラのシェア、AWSが26%に後退 Google Cloudは16%に上昇 市場全体は過去最大の高成長率へ 2026年第3四半期調査
-
4
Sakana AI「初のモバイルアプリ」開発中 テスターも募集
-
5
「勝手に社外AIを使う」エース社員に困っています……どうすべき?
-
6
【図解あり】マルチエージェント設計「15のパターン」 GitHub、Google、Siemensの知見を一気に整理
-
7
Qwen3.8-27Bベースに「西洋の価値観を強化」したオープンモデル登場、「逆に偏っている」との批判も Hermes Agent開発元
-
8
情報漏えい続出でフィッシングに変化? “その人専用詐欺メール”登場の懸念
-
9
AIによるコンテンツの“無断加工”は禁止――AVメーカーが注意喚起 「著作権の侵害にあたる」と指摘
-
10
「トイレ」に凝ったらAI需要で大躍進――TOTO、利益の7割かせぐ「半導体」ビジネスの正体
SpecialPR
ITmedia AI+ SNS
 @itm_aiplusをフォロー
インフォメーション
注目情報をチェック
ITmedia AI+をフォロー
あなたにおすすめの記事PR